Trading de criptomonedas de baja latencia: ubicación de los servidores de los exchanges, latencia real de API y dónde alojar tu bot 07/11/2026 – Publicado en: Arbitrage Software, cryptoarbitrage software
Trading de criptomonedas de baja latencia: ubicación de los servidores de los exchanges, latencia real de API y dónde alojar tu bot
Un bot de arbitraje de criptomonedas puede tener una buena señal y aun así perder la operación, porque cuando su orden llega al exchange el precio que vio ya no existe. Esta guía explica dónde ejecutan realmente los principales exchanges sus motores de matching, por qué un ping a un host de API casi no te dice nada, qué medimos desde un servidor real, cómo medir la latencia correctamente desde tu propia máquina y cómo elegir una región de alojamiento cuando tu estrategia opera en dos exchanges de países distintos.
- Qué significa baja latencia en el trading de criptomonedas
- El presupuesto de latencia: adónde van los milisegundos
- Dónde ejecutan los exchanges de criptomonedas sus motores de matching
- La trampa de la CDN: por qué el ping engaña
- Lo que medimos desde un servidor en Montreal
- Paso a paso: cómo medir correctamente la latencia de los exchanges
- Datos de mercado por WebSocket y sincronización del reloj
- Cómo elegir una región de alojamiento para arbitraje entre dos exchanges
- Cómo la latencia se convierte en dinero
- Colocation, VPS y qué es realista para traders independientes
- La latencia dentro de tu propio software
- Riesgos y limitaciones
- Preguntas frecuentes
Qué significa baja latencia en el trading de criptomonedas
Respuesta corta: el trading de criptomonedas de baja latencia consiste en acortar el tiempo entre un cambio de precio en un exchange y la llegada de tu orden al motor de matching de ese exchange. La mayor parte de ese tiempo es distancia física: los principales exchanges ejecutan sus motores en regiones de nube concretas, sobre todo en Tokio, Singapur y Hong Kong, y un bot alojado en otro continente va de 150 a 250 milisegundos por detrás de un bot alojado junto al motor. La segunda parte más grande es overhead evitable: conexiones en frío, polling por REST, un reloj mal sincronizado y código lento.
En forex, la latencia es una historia sobre unos pocos centros de datos muy conocidos en Londres, Nueva York y Tokio, y sobre los puentes de liquidez de los brókeres. En cripto el panorama es diferente. No existe un campus compartido de exchanges: cada exchange elige su propia región de nube, la mayoría funcionan sobre infraestructura de nube pública y sus APIs suelen estar detrás de redes de distribución de contenido (CDN) que hacen que el exchange parezca cercano cuando no lo está. Eso hace que la medición sea a la vez más fácil (puedes alquilar un servidor en la misma región de nube por el precio de una cena) y más engañosa (las pruebas obvias miden lo que no es).
Cuánto importa la latencia depende de la estrategia:
| Estrategia | Cuánto suele durar la oportunidad | Latencia "suficiente" |
|---|---|---|
| Arbitraje entre exchanges con transferencias entre ellos | Minutos (limitado por las confirmaciones de la blockchain) | Segundos; las comisiones y los tiempos de transferencia importan mucho más |
| Operaciones de tasa de financiación (funding rate) y de base spot-futuros | De horas a días | No es crítica; la calidad de ejecución importa más que la velocidad |
| Arbitraje de cobertura (dos patas) con saldos prefinanciados en ambos exchanges | De cientos de milisegundos a segundos en pares de capitalización media, menos en los principales | Decenas de milisegundos hasta cada exchange |
| Arbitraje de latencia contra una plataforma más lenta, compitiendo con market makers | Milisegundos | Pocos milisegundos (un dígito) hasta la plataforma negociada, misma región de nube |
Si tu ventaja proviene de diferencias estructurales lentas, como el arbitraje de tasa de financiación o transferencias limitadas por comisiones de retiro y tiempos de confirmación de la red, no necesitas nada de esta guía más allá de un servidor estable. Si operas diferencias de precio entre libros de órdenes, es la diferencia entre que te ejecuten y perseguir el precio.
El presupuesto de latencia: adónde van los milisegundos
La "latencia" no es un único número. Una orden que reacciona a un movimiento del mercado pasa por una cadena de etapas, y cada etapa añade tiempo. Pensar en términos de presupuesto te indica qué partes puedes cambiar y cuáles no.
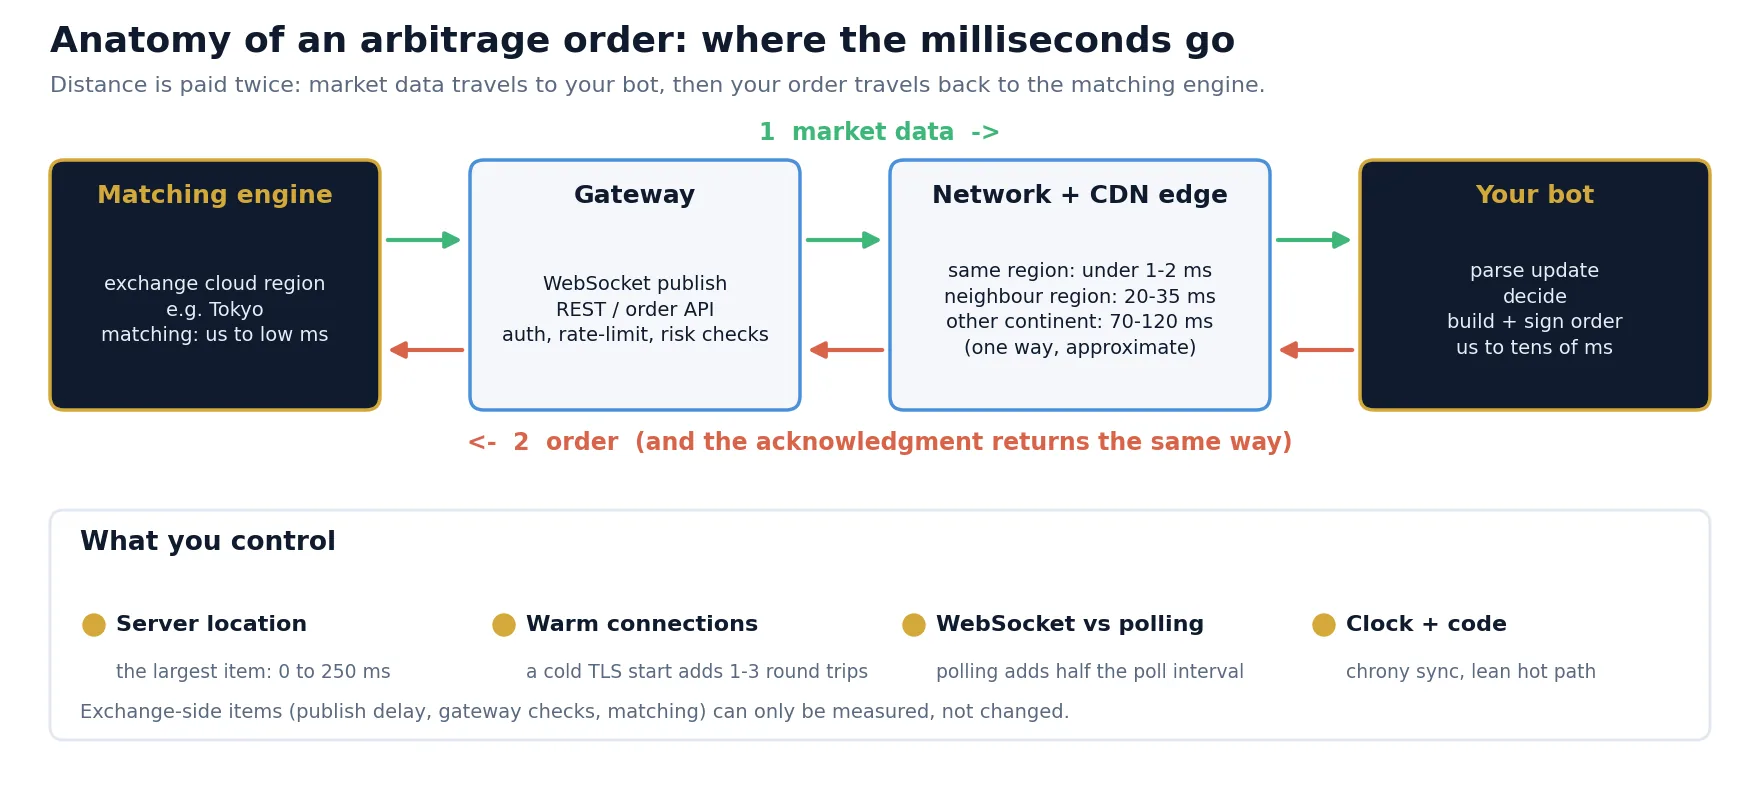
| Componente | Rango típico (aproximado) | Quién lo controla |
|---|---|---|
| Publicación de datos de mercado (del motor al gateway WebSocket) | De menos de un milisegundo a varios milisegundos; más en streams agregados o limitados | Exchange; tú eliges el tipo de stream |
| Red, ida, misma región de nube | Menos de 1 ms a unos 2 ms | Tú, con la elección del alojamiento |
| Red, ida, regiones asiáticas vecinas (p. ej., Tokio a Hong Kong) | Unos 20 a 35 ms | Tú |
| Red, ida, entre continentes (p. ej., Europa o Norteamérica a Tokio) | Unos 70 a 120 ms | Tú |
| Establecimiento de conexión (handshakes TCP y TLS) en una conexión en frío | De uno a tres viajes de ida y vuelta de red adicionales | Tú: mantén las conexiones calientes |
| Tu propio código de decisión | De microsegundos a decenas de milisegundos | Tú |
| Gateway de la API, autenticación, límites de solicitudes y controles de riesgo | De unos pocos milisegundos a decenas de milisegundos, con picos en mercados volátiles | Exchange |
| Matching | De microsegundos a pocos milisegundos | Exchange |
El patrón es claro: los dos elementos que controlas y que se miden en decenas o cientos de milisegundos son dónde está tu servidor y si tus conexiones están calientes. Todo lo demás pertenece al exchange o es pequeño cuando el software está bien escrito. Por eso el resto de esta guía se centra en la ubicación y la medición.
Dónde ejecutan los exchanges de criptomonedas sus motores de matching
Los exchanges rara vez publican la ubicación exacta de sus motores de matching, pero la mayoría funcionan en nube pública, y la región puede deducirse a partir de mediciones de latencia realizadas desde muchas regiones de nube. Las mediciones independientes publicadas por terceros en 2026 coinciden en la mayoría de las grandes plataformas. La tabla resume las regiones reportadas públicamente. Tómala como punto de partida para tus propias pruebas, no como garantía: los exchanges migran (de BitMEX, por ejemplo, se informó que trasladó su motor de Dublín a Tokio en 2025).
| Exchange | Región del motor reportada públicamente | Región de nube para probar primero | Confianza |
|---|---|---|---|
| Binance | Tokio | AWS ap-northeast-1 | Alta: coherente entre mediciones independientes |
| Bybit | Singapur | AWS ap-southeast-1 | Alta |
| OKX | Hong Kong | AWS ap-east-1 | Alta |
| Gate.io, KuCoin, Bitget, HTX | Tokio | AWS ap-northeast-1 | Media a alta |
| Coinbase (spot) | Estados Unidos, costa este | AWS us-east-1 | Media: API detrás de una CDN, mide las confirmaciones de órdenes |
| Kraken | Europa | Prueba Londres, Dublín y Fráncfort | Baja: las fuentes publicadas no coinciden |
| Deribit | Zona de Londres | AWS eu-west-2 | Media a alta |
De ahí se derivan dos conclusiones prácticas. Primero, Tokio es lo más parecido que tiene el mundo cripto a un centro de trading central: un servidor allí está a pocos milisegundos de Binance y de varias otras grandes plataformas, a unos 25 ms (ida) de Hong Kong y a unos 35 ms (ida) de Singapur. Segundo, cualquier estrategia que combine un exchange asiático con Coinbase o una plataforma europea tiene un piso físico de 70 a 120 ms (ida) entre los dos motores, hagas lo que hagas con tu propio servidor.
Alojar un servidor en un país determinado no cambia qué exchanges puedes usar. Respeta los términos de servicio de cada exchange y las normas de tu propia jurisdicción; nunca uses servidores ni VPN para eludir restricciones geográficas.
La trampa de la CDN: por qué el ping engaña
El error más común es medir la latencia con ping o con el tiempo necesario para abrir una conexión TCP con el nombre de host de la API. Casi todos los grandes exchanges colocan sus endpoints públicos REST y WebSocket detrás de una CDN o de un balanceador de carga en la nube con puntos de presencia en todo el mundo. Cuando te conectas a api.binance.com desde Europa o Norteamérica, el servidor que responde a tu handshake TCP es un nodo de borde en una ciudad cercana, no el motor de matching de Tokio. El handshake tarda unos milisegundos; después el borde reenvía tu solicitud por el backbone del proveedor hasta el origen real, y ahí es donde se va el tiempo.
Así, un ping de 5 ms al nombre de host de un exchange puede coexistir con un tiempo real de solicitud de 150 ms. Los únicos números que significan algo son los que incluyen el viaje hasta el origen: el tiempo hasta el primer byte de una respuesta real de la API en una conexión ya abierta, el retraso entre la marca de tiempo del evento del propio exchange y tu hora de recepción en el WebSocket, y el tiempo desde que envías una orden hasta que recibes su confirmación.
Medido por BJF Trading Group el 7 de noviembre de 2026 desde un servidor web en Montreal (Leaseweb), endpoints públicos de hora, dos ejecuciones de una solicitud en frío más 20 en caliente por exchange.
Lo que medimos desde un servidor en Montreal
Para mostrar el efecto con números reales en lugar de afirmaciones de proveedores, ejecutamos una pequeña sonda desde el servidor web que aloja este sitio, en Montreal. Para ocho exchanges abrió una conexión, envió una solicitud (en frío) y luego 20 solicitudes más por la misma conexión keep-alive (en caliente), a cuatro solicitudes por segundo, y repitió toda la ejecución dos veces. El endpoint fue la llamada pública de hora del servidor de cada exchange, que casi no realiza trabajo, así que el resultado se acerca al tiempo puro de transporte más gateway.
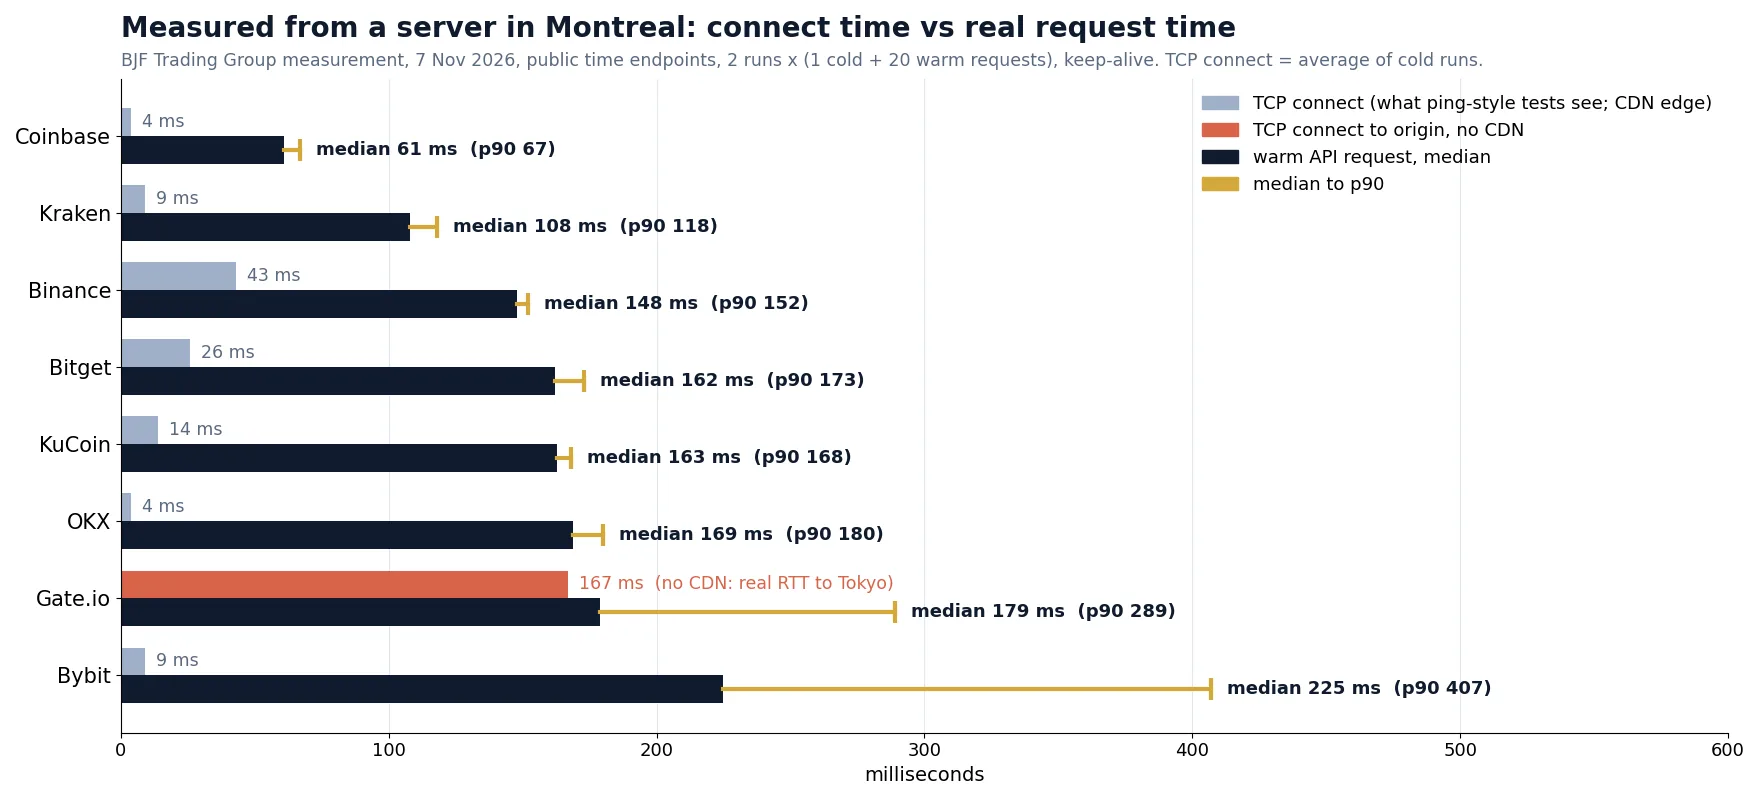
| Exchange | Front-end visto desde Montreal | Conexión TCP, ms | Primera solicitud en frío, ms | Mediana de solicitud en caliente, ms | p90 en caliente, ms |
|---|---|---|---|---|---|
| Coinbase | Borde de Cloudflare | 4 | 119 a 140 | 61 | 67 |
| Kraken | Borde de Cloudflare | 3 a 15 | 162 a 179 | 108 | 118 |
| Binance | Borde de CloudFront | 11 a 74 | 210 a 277 | 148 | 152 |
| Bitget | Borde de Cloudflare | 15 a 37 | 226 a 247 | 162 | 173 |
| KuCoin | Borde de Cloudflare | 6 a 23 | 220 a 244 | 163 | 168 |
| OKX | Borde de Cloudflare | 3 a 4 | 217 a 232 | 169 | 180 |
| Gate.io | Directo, dirección de AWS en Tokio | 167 | 668 a 718 | 179 | 289 |
| Bybit | Borde de CloudFront | 8 a 10 | 278 a 281 | 225 | 407 |
De esta pequeña prueba salen cuatro lecciones:
- El tiempo de conexión no significa nada detrás de una CDN. OKX respondió al handshake TCP en 3 a 4 ms, pero cada solicitud real tardó unos 170 ms, porque el trabajo se hace en Hong Kong.
- La clasificación sigue a la geografía. Coinbase (costa este de EE. UU.) es la más rápida desde Montreal, Kraken (Europa) la segunda, y los exchanges asiáticos se agrupan entre 150 y 225 ms. Desde Tokio el orden sería el inverso.
- Las conexiones en frío son caras. Sin un borde cerca, cada viaje de ida y vuelta del handshake cruza el Pacífico: la primera solicitud a Gate.io tardó unos 0.7 segundos y las siguientes unos 0.18 segundos. Un bot que abre una conexión nueva cuando ve una señal ya ha perdido.
- Las colas importan. La mediana de Bybit fue de 225 ms, pero una de cada diez solicitudes tardó más de 400 ms. Una pata de arbitraje es tan rápida como sus casos lentos, así que mira siempre el p90 y el p99, no solo la mediana.
Estos números describen un servidor web en una tarde, no una configuración de trading, e incluyen el procesamiento en el gateway de cada exchange. No son una clasificación de exchanges. Su propósito es mostrar la magnitud de los efectos: la geografía y la gestión de conexiones explican más del 90% del retraso que sufre un bot lejano.
Paso a paso: cómo medir correctamente la latencia de los exchanges
Puedes reproducir una medición significativa desde cualquier servidor en una hora. El método siguiente es el que recomendamos antes de elegir una región de alojamiento o después de cualquier cambio en tu infraestructura.
Para el paso 2, basta con un simple curl para empezar. Repetir la URL hace que curl reutilice una conexión; la primera línea es la solicitud en frío y el resto son en caliente:
curl -s –rate 4/s -w "%{num_connects} %{time_connect} %{time_starttransfer}\n" -o /dev/null URL -o /dev/null URL -o /dev/null URL
Para los pasos 4 y 5 necesitas unas pocas líneas de código en el lenguaje que usa tu bot, porque la medición debe pasar por la misma biblioteca cliente, el mismo parser JSON y la misma configuración de conexión que el trading real. Un número producido por otra herramienta te habla de esa herramienta.
Datos de mercado por WebSocket y sincronización del reloj
Para cualquier cosa sensible al tiempo, los datos de mercado deben venir de streams WebSocket, no de polling por REST. Un bucle de polling que solicita el libro de órdenes cada 200 ms añade de media 100 ms de espera antes siquiera de ver un cambio, además del tiempo de la solicitud, y consume el límite de solicitudes que necesitas para las órdenes. Un stream WebSocket envía cada actualización en cuanto el exchange la publica. Los detalles de streams, libros de órdenes locales y comprobación de secuencias se tratan en nuestra guía sobre cómo conectarse a las APIs de exchanges de criptomonedas para arbitraje; aquí nos centramos en los tiempos.
Cómo medir el retraso del feed
La mayoría de los mensajes WebSocket de los exchanges llevan una marca de tiempo fijada por el exchange: una hora de evento, de operación o de mensaje, normalmente en milisegundos. Réstala de tu hora local de recepción y obtienes el retraso del feed, que incluye el retraso interno de publicación del exchange y el viaje por la red. Regístralo por stream, no solo como media: los snapshots de profundidad, las actualizaciones incrementales del libro y los streams de operaciones pueden comportarse de forma diferente, y los streams agregados que publican cada 100 ms mostrarán un patrón en diente de sierra.
Por qué importa el reloj
Las mediciones de ida solo son tan buenas como la concordancia entre tu reloj y el del exchange. Si el reloj de tu servidor va 15 ms atrasado, cada retraso del feed parecerá 15 ms mejor de lo que es. En un servidor en la nube, ejecuta chrony con el servicio de hora del proveedor y comprueba chronyc tracking: un desfase de alrededor de un milisegundo es una base sólida para comparar regiones. Muchos exchanges también ofrecen un endpoint de hora del servidor; compararlo con tu reloj teniendo en cuenta la mitad del viaje de ida y vuelta medido da una comprobación aproximada. Los endpoints de órdenes que aceptan una ventana de recepción (antigüedad máxima permitida de la marca de tiempo de la solicitud) también rechazarán órdenes cuando tu reloj se desvíe, otro motivo para mantenerlo sincronizado.
Mide la ruta de la orden por separado
El retraso del feed te dice lo antigua que es tu visión del mercado. El ciclo de la orden te dice cuánto se tarda en actuar en consecuencia. Ambos suelen ser distintos: las solicitudes de órdenes pasan por autenticación, control de límites de solicitudes y controles de riesgo que un stream de datos de mercado no tiene. Algunos exchanges, entre ellos Binance, ofrecen un endpoint de prueba de órdenes que valida una orden firmada sin enviarla al motor de matching; mide la parte de red y gateway. Si el exchange ofrece el envío de órdenes por una sesión WebSocket o FIX, mídelo también, porque una sesión persistente evita el overhead por solicitud.
Cómo elegir una región de alojamiento para arbitraje entre dos exchanges
Para un solo exchange la respuesta es sencilla: alquila un servidor en la misma región de nube que su motor. El arbitraje entre dos exchanges es un problema de geometría, porque los motores están en lugares distintos y solo puedes estar junto a uno de ellos.
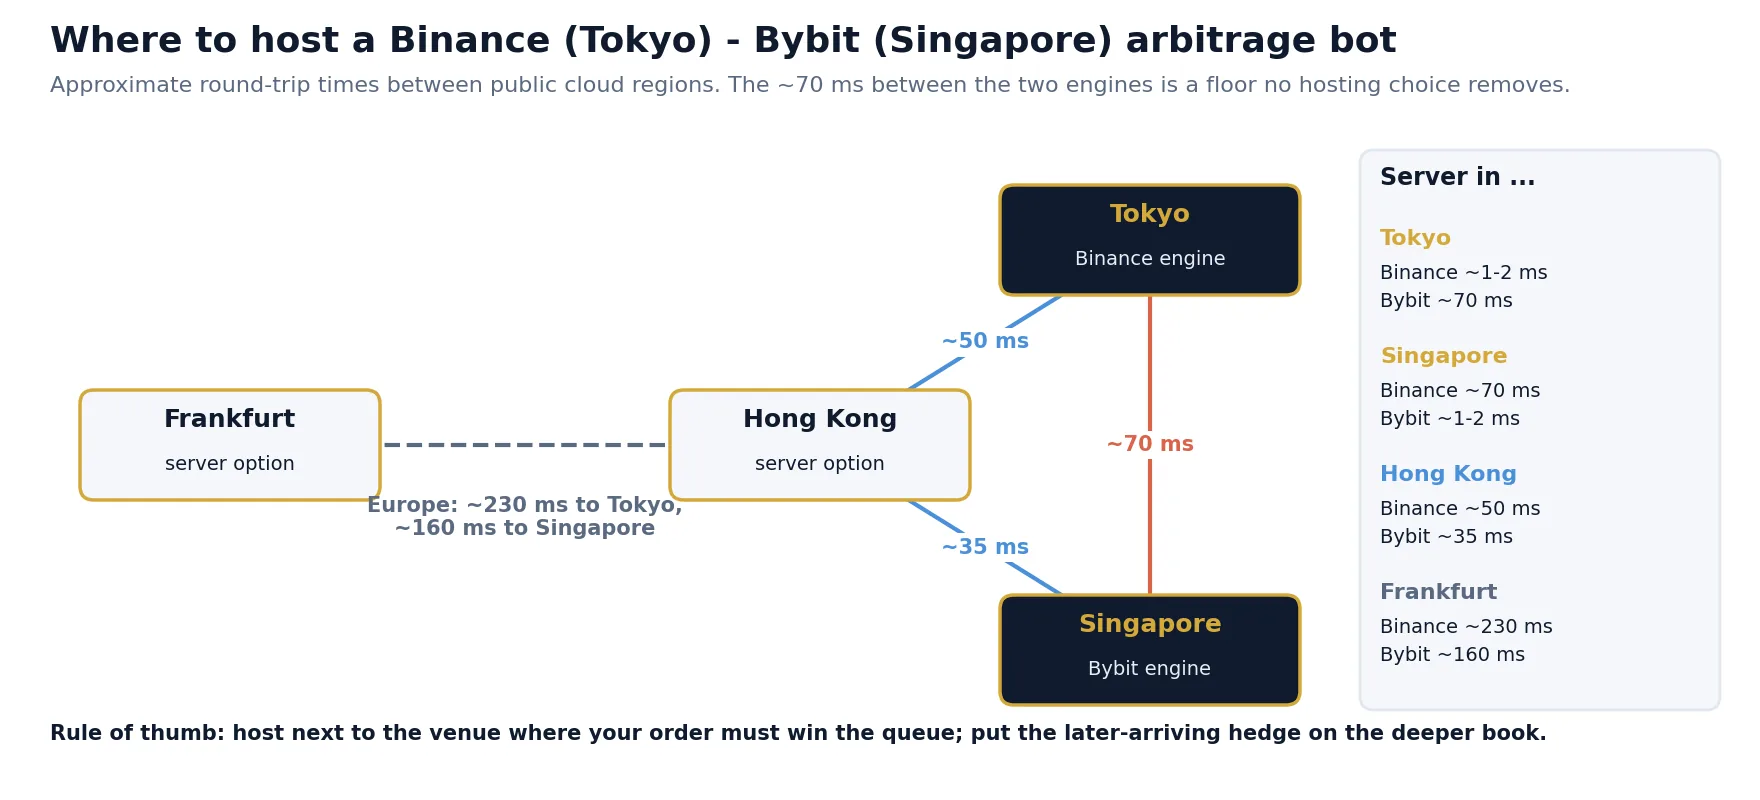
Toma un arbitraje de cobertura entre Binance (Tokio) y Bybit (Singapur). El viaje de ida y vuelta entre ambas regiones es de unos 70 ms, es decir, aproximadamente 35 ms de ida. Estas son las principales opciones:
| Ubicación del servidor | Ida y vuelta a Binance | Ida y vuelta a Bybit | Valoración |
|---|---|---|---|
| Tokio | Unos 1 a 2 ms | Unos 70 ms | Rápido en Binance, la pata de Bybit paga toda la distancia |
| Singapur | Unos 70 ms | Unos 1 a 2 ms | La imagen especular |
| Hong Kong | Unos 50 ms | Unos 35 ms | Lento en ambas patas; rara vez la mejor opción para dos plataformas |
| Europa (p. ej., Fráncfort) | Unos 230 ms | Unos 160 ms | Fuera de la carrera para cualquier estrategia sensible al tiempo |
Los tiempos de ida y vuelta son valores típicos aproximados entre regiones de nube pública; consulta las cifras actuales entre regiones de tu proveedor y mide desde tus propios servidores.
La observación clave es que la información siempre tiene que recorrer la distancia entre los dos exchanges. Si el precio se mueve en Binance y la cotización desactualizada está en Bybit, un servidor en Tokio ve el movimiento al instante y su orden viaja 35 ms hasta Singapur; un servidor en Singapur recibe el movimiento con 35 ms de retraso y su orden llega al instante. El total es el mismo. Lo que cambia es qué parte de la cadena espera y, por tanto, qué decisión debe guiar la elección:
- Aloja junto a la plataforma donde la orden debe ganar. Si tu beneficio depende de tomar una cotización antes que otros traders en un exchange, compite donde se decide esa cola. Allí la información de todos sobre el otro exchange llega a la misma velocidad, pero tu orden no tiene que viajar.
- Pon la cobertura en el libro más profundo. La pata que llega más tarde a su exchange debe ser la menos sensible a unos pocos milisegundos: el libro más líquido, donde es poco probable que el precio de cobertura se mueva mucho.
- Conoce rápido el estado de ejecución. Estar junto al exchange donde son habituales las ejecuciones parciales te permite dimensionar la cobertura con información precisa, lo que reduce el riesgo sin cubrir.
- Divide solo cuando compense. Dos procesos, uno por región, pueden mantener cada uno un libro de órdenes local y reaccionar localmente, pero deben coordinarse a través del mismo enlace de 70 ms. Esto añade complejidad y modos de fallo y merece la pena sobre todo en configuraciones profesionales.
Para estrategias entre tres o más plataformas asiáticas, Tokio suele ser el centro práctico por el número de grandes exchanges que hay allí. Para pares que incluyen una plataforma estadounidense o europea, la pata intercontinental domina y la estrategia debe tolerar de 70 a 120 ms de ida, lo que descarta la competencia pura por velocidad y favorece diferencias más grandes y duraderas.
Cómo la latencia se convierte en dinero
Una diferencia de precio entre dos libros de órdenes no es un premio fijo. Otros traders también la ven, los market makers actualizan sus cotizaciones y la diferencia desaparece en un tiempo que depende del activo y de la plataforma. Una forma sencilla de verlo es suponer que cada oportunidad sobrevive un tiempo aleatorio con una vida media y preguntarse qué probabilidad hay de que siga ahí cuando llegue tu orden.
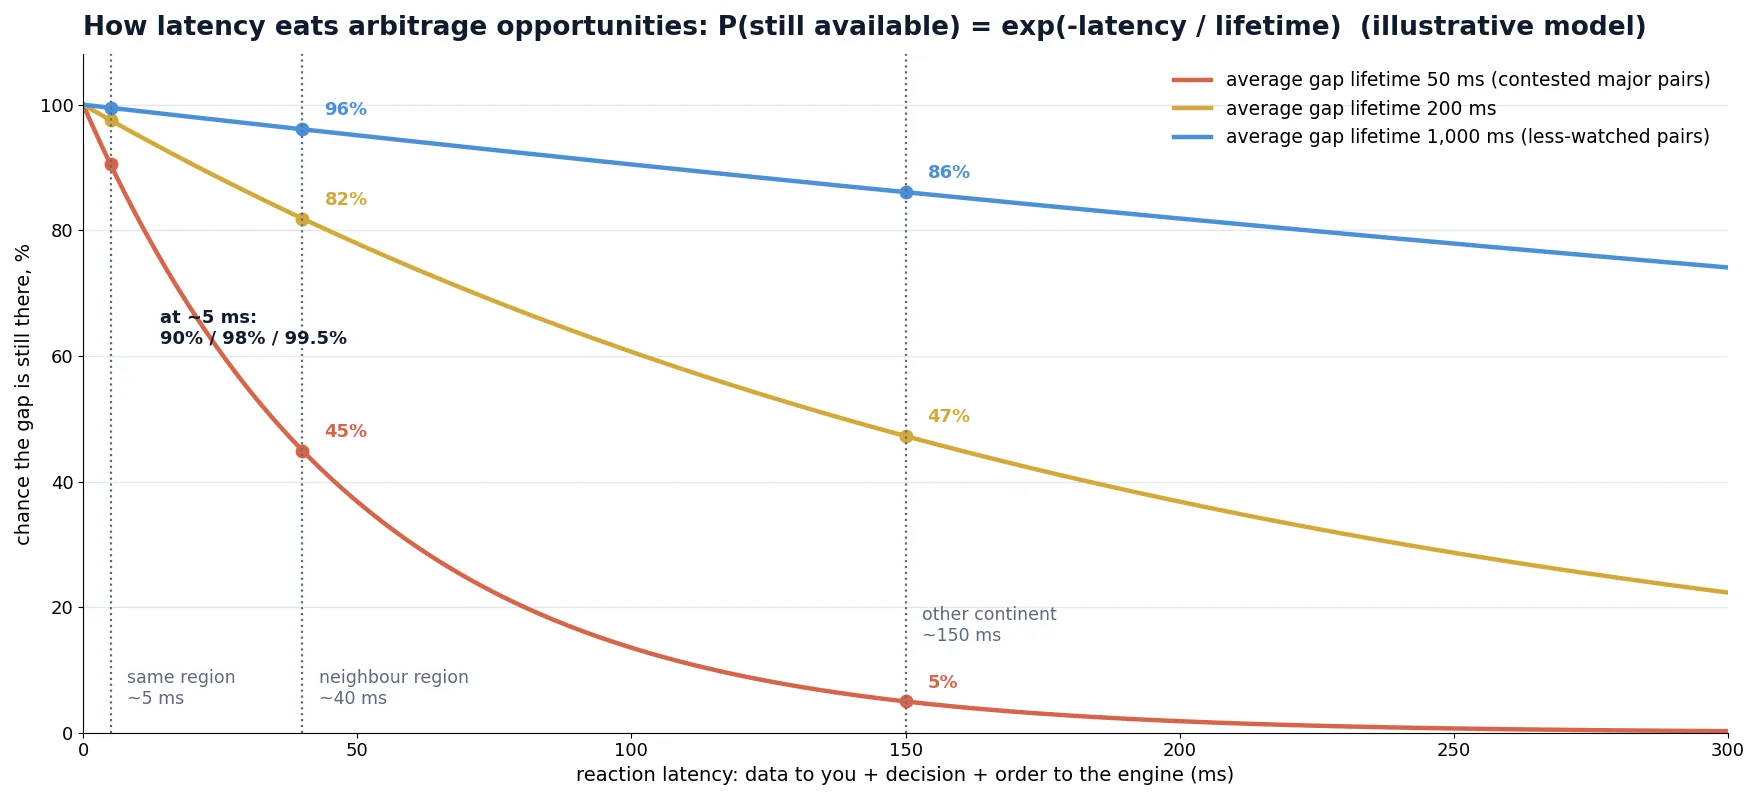
En este modelo, la probabilidad de que una diferencia siga ahí tras un tiempo de reacción de L milisegundos es exp(−L / τ), donde τ es la vida media de la diferencia. Los resultados para tres tiempos de reacción, que corresponden aproximadamente a un servidor en la misma región (5 ms), en una región vecina (40 ms) y en otro continente (150 ms):
| Vida media de la diferencia | Reacción 5 ms | Reacción 40 ms | Reacción 150 ms |
|---|---|---|---|
| 50 ms (diferencias disputadas en pares principales) | 90% | 45% | 5% |
| 200 ms | 98% | 82% | 47% |
| 1,000 ms (pares menos vigilados) | 99.5% | 96% | 86% |
Ahora ponle dinero. Supón que una estrategia encuentra 200 señales al día con una ventaja neta del 0.10% en una operación de 5,000 USDT, es decir, 5 USDT por señal capturada, y que una señal perdida cuesta de media 1.5 USDT, porque una pata se ejecutó y hay que deshacerla. Para diferencias con una vida de 200 ms:
| Ubicación del servidor | Capturadas | Esperado por señal | Por día (200 señales) |
|---|---|---|---|
| Misma región (5 ms) | 98% | 0.98 × 5 − 0.02 × 1.5 = 4.87 USDT | Unos 974 USDT |
| Región vecina (40 ms) | 82% | 0.82 × 5 − 0.18 × 1.5 = 3.83 USDT | Unos 766 USDT |
| Otro continente (150 ms) | 47% | 0.47 × 5 − 0.53 × 1.5 = 1.56 USDT | Unos 311 USDT |
Los números son hipotéticos, pero la conclusión es sólida: trasladar un bot de otro continente a la región correcta puede multiplicar el resultado de la misma estrategia, mientras que pasar de una región vecina a la misma región aporta una mejora menor pero todavía significativa. También muestra el límite: para diferencias que duran un segundo o más, la latencia apenas importa, y las comisiones, el slippage y el inventario deciden el resultado. Antes de gastar en infraestructura, comprueba cuánto duran realmente las diferencias que operas; el escáner gratuito de arbitraje de criptomonedas te permite ver en directo las diferencias reales de precio entre exchanges.
Colocation, VPS y qué es realista para traders independientes
En forex y en renta variable, colocation significa alquilar espacio en rack en el mismo centro de datos que la bolsa o los servidores del bróker, y los principales hubs son bien conocidos (consulta nuestra guía sobre VPS para arbitraje forex y hubs de colocation). En cripto, el equivalente para la mayoría de los traders es simplemente un servidor virtual en la misma región de nube que el exchange. Como el propio motor funciona en esa nube, un servidor en la misma región ya está a uno o dos milisegundos de él, por un coste de decenas de dólares al mes.
| Opción | Latencia típica hasta el motor | Coste | Para quién es |
|---|---|---|---|
| PC doméstico o conexión de oficina | De decenas a cientos de ms, inestable | Ninguno | Monitorización, estrategias lentas, pruebas |
| VPS en otra región o continente | 70 a 250 ms | Bajo | Arbitraje de financiación, de base y basado en transferencias |
| Servidor en la nube en la región del exchange | Unos 1 a 2 ms de ida y vuelta en la red | Bajo a moderado | Arbitraje de cobertura y la mayoría de las estrategias minoristas sensibles a la latencia |
| Misma zona de disponibilidad, instancias optimizadas | Mejoras de red por debajo del milisegundo | Moderado | Equipos profesionales que ya han optimizado todo lo demás |
| Conectividad dedicada o programas para market makers | La más baja disponible | Alto, normalmente ligado a niveles de volumen | Market makers e instituciones |
Dentro de una región, la zona de disponibilidad puede suponer una diferencia adicional de una fracción de milisegundo. Esto solo importa cuando compites con market makers profesionales en los pares más líquidos, y merece la pena probarlo solo después de haber resuelto los elementos más grandes: región, conexiones calientes, datos por WebSocket y tu propio código. Los principios generales de lo rápido que debe ser un servidor, y por qué la baja latencia importa más que unas especificaciones altas, se tratan en qué tan rápido debe ser tu VPS para arbitraje.
La latencia dentro de tu propio software
Una vez que el servidor está en el lugar correcto, los retrasos restantes son sobre todo autoinfligidos. Los culpables habituales, en el orden en que los vemos:
- Abrir conexiones bajo demanda. Mantén vivas las conexiones REST con un pool de conexiones, envía periódicamente una solicitud ligera para que no se cierren las conexiones inactivas y reconecta los WebSockets de forma proactiva antes del tiempo máximo de sesión del exchange.
- Polling en lugar de streaming. Usa datos de mercado por WebSocket y, cuando esté disponible, envío de órdenes por WebSocket o FIX.
- Trabajo pesado en la ruta crítica. Escribir logs en disco, analizar grandes mensajes JSON campo por campo o recalcular todo el libro de órdenes en cada actualización añaden milisegundos. Haz lo mínimo antes de enviar la orden y deja el resto para después.
- Penalizaciones por límite de solicitudes. Un bot que supera el límite de peso de las solicitudes es rechazado o bloqueado temporalmente, lo que equivale a una latencia infinita. Reparte el presupuesto de solicitudes por exchange y reduce el ritmo antes del límite, no después.
- Recolección de basura y contención de CPU. En un VPS compartido pequeño, otros inquilinos y las pausas de limpieza de memoria pueden añadir decenas de milisegundos en momentos aleatorios. Eso aparece en el p99, no en las medias.
- Envío secuencial de las patas. Si las dos patas de una cobertura son independientes, envíalas en paralelo en lugar de esperar la primera confirmación.
El software VIP Crypto Arbitrage de BJF Trading Group se conecta a exchanges centralizados de spot y futuros mediante sus APIs nativas y funciona en un servidor que tú eliges, así que los principios de ubicación de esta guía se le aplican directamente. Para la lógica de las estrategias basadas en latencia, consulta nuestra guía de arbitraje de latencia y, para el panorama general de las estrategias entre exchanges, la visión general del arbitraje de criptomonedas.
Riesgos y limitaciones
- La latencia no es una ventaja por sí sola. Ser rápido solo ayuda si la estrategia es rentable después de comisiones, slippage y costes de inventario. Un bot rápido con ventaja negativa pierde dinero más rápido.
- Las ubicaciones cambian. Los exchanges migran sus motores y cambian de proveedor de CDN. Una región que era la correcta el año pasado puede no serlo hoy; vuelve a medir con regularidad.
- Las mediciones son locales. Nuestros números de Montreal, y cualquier tabla publicada, describen un lugar y un momento. Solo las mediciones desde tu propio servidor, a través de tu propio software, son válidas para tus decisiones.
- En situaciones de estrés dominan los retrasos del lado del exchange. En mercados violentos, los gateways ponen en cola las solicitudes y las confirmaciones se ralentizan para todos. Tu estrategia debe tolerarlo, por ejemplo limitando el tamaño de la posición cuando aumentan los tiempos de confirmación.
- La carrera armamentística no tiene fin. En los pares más líquidos, las firmas profesionales invierten en velocidad mucho más de lo que puede un trader independiente. Busca diferencias que duren lo suficiente para tu configuración en lugar de competir por las más cortas.
- Cumplimiento normativo. La ubicación del servidor no cambia tu situación legal. Usa solo exchanges y productos que estén disponibles para ti y respeta los términos de las APIs y los límites de solicitudes.
Comprueba cuánto duran las diferencias reales antes de optimizar
Observa las diferencias reales de precio entre exchanges centralizados, su tamaño y la rapidez con que se cierran. Después decide cuánta latencia puede tolerar tu estrategia.
Obtén el Crypto Arbitrage Scanner gratuitoSoftware VIP Crypto Arbitrage
Escáner de arbitraje gratis + curso breve por email
Recibe el enlace al escáner gratuito y algunos emails breves y prácticos de Boris: qué significa realmente una diferencia de precio después de costos, cómo probar una estrategia antes de arriesgar dinero real y qué herramientas se adaptan a tu mercado. Sin exageraciones. Los emails se envían en inglés.
Preguntas frecuentes
¿Qué es el trading de criptomonedas de baja latencia?
Es operar con el menor retraso posible entre un evento de mercado en un exchange y la llegada de tu orden al motor de matching de ese exchange. En la práctica significa alojar el servidor de trading en la misma región de nube que el exchange, usar datos por WebSocket y conexiones calientes, y mantener rápido tu propio código.
¿Dónde están los servidores de Binance?
Las mediciones de latencia independientes sitúan de forma constante el motor de matching de Binance en Tokio, en la región AWS ap-northeast-1. Su API pública está detrás de una CDN, así que el servidor que responde a un ping suele ser un nodo de borde cercano a ti; mide los tiempos reales de solicitudes y órdenes para confirmarlo.
¿Es el ping una buena forma de medir la latencia de un exchange?
No. La mayoría de las APIs de exchanges están detrás de CDN, así que los tiempos de ping y de conexión TCP solo miden la distancia al borde más cercano. En nuestra prueba desde Montreal, OKX respondió al handshake TCP en 3 a 4 ms, pero cada solicitud real tardó unos 170 ms. En su lugar, mide el tiempo hasta el primer byte en una conexión caliente, el retraso del feed y el tiempo de confirmación de las órdenes.
¿Necesito colocation para el arbitraje de criptomonedas?
Para la mayoría de los traders independientes, no. Como los principales exchanges funcionan en regiones de nube pública, un servidor en la misma región ya está a uno o dos milisegundos del motor. Existen programas de conectividad dedicada para market makers y cuentas de alto volumen, pero solo importan cuando todo lo demás ya está optimizado.
¿Qué latencia es suficiente para el arbitraje de criptomonedas?
Depende de cuánto duren las diferencias. Las estrategias de tasa de financiación, de base y basadas en transferencias funcionan con segundos de retraso. El arbitraje de cobertura con saldos en ambos exchanges suele necesitar decenas de milisegundos hasta cada plataforma. Competir por las diferencias más cortas en los pares principales requiere pocos milisegundos (un dígito) desde la misma región.
¿Qué región es mejor para operar en varios exchanges de criptomonedas?
Tokio suele ser la mejor ubicación única para los exchanges asiáticos, porque Binance y varias otras grandes plataformas están allí, y Hong Kong y Singapur quedan a unos 25 a 35 ms (ida). Si tus exchanges están repartidos entre continentes, elige la ubicación de la plataforma donde tus órdenes deben ser más rápidas.
¿Es WebSocket más rápido que REST para datos de mercado cripto?
Sí, a efectos prácticos. Un stream WebSocket envía cada actualización cuando el exchange la publica, mientras que el polling por REST añade tiempo de espera entre solicitudes más una solicitud completa en cada comprobación, y consume los límites de solicitudes. Usa REST principalmente para snapshots, consultas de cuenta y recuperación.
Este artículo es educativo y no constituye asesoramiento financiero. Las cifras de latencia de la tabla de Montreal fueron medidas por BJF Trading Group el 7 de noviembre de 2026 desde un servidor y no son una clasificación de exchanges; la información sobre regiones se basa en mediciones de terceros reportadas públicamente y puede cambiar. Las cifras y los gráficos marcados como ilustrativos o aproximados son modelos y valores típicos, no mediciones de ningún exchange o trader concreto.
