Statistische Arbitrage verstehen: Ein Weg zum profitablen Trading Mittwoch, der 21. Juni 2023 – Posted in: Arbitrage Software, cryptoarbitrage software – Tags: arbitrage software, forex arbitrage, statistical arbitrage, statistical arbitrage bot, statistical arbitrage software
Statistische Arbitrage, oft „Stat Arb“ genannt, ist eine beliebte quantitative Handelsstrategie, die von Hedgefonds und Eigenhandelsfirmen weithin eingesetzt wird. Das Grundprinzip besteht darin, Preisineffizienzen zwischen verwandten Finanzinstrumenten auszunutzen. Trader, die Stat Arb nutzen, stützen sich auf komplexe mathematische Modelle, um Handelsgelegenheiten zu erkennen – damit ist diese Strategie ein Teilbereich des algorithmischen Handels.
Ursprünge der statistischen Arbitrage
Die statistische Arbitrage hat ihre Wurzeln in den 1980er-Jahren, als sie von quantitativen Analysten an der Wall Street, umgangssprachlich „Quants“ genannt, entwickelt wurde. Die Strategie wurde zunächst an den Aktienmärkten angewandt, wo Aktienpaare anhand ihrer Kointegration ausgewählt wurden – einer statistischen Eigenschaft, die anzeigt, dass die Preisdifferenz zwischen den beiden Aktien im Zeitverlauf zum Mittelwert zurückkehrt. Seitdem hat sich Stat Arb weiterentwickelt und wurde an verschiedene andere Märkte angepasst, darunter Forex und Kryptowährungen.
Das Grundprinzip
Statistische Arbitrage beruht auf dem Prinzip der Mean Reversion (Rückkehr zum Mittelwert) und dem Gesetz der großen Zahlen. Die zugrunde liegende Annahme ist, dass die relativen Preise historisch korrelierter Finanzinstrumente im Laufe der Zeit zu ihrem Mittelwert zurückkehren. Genau hier setzt die statistische Arbitrage an – sie nutzt Preisunterschiede zwischen diesen korrelierten Instrumenten, wenn sie von ihrer historischen Norm abweichen.
Nehmen wir zum Beispiel zwei Aktien, die sich historisch gemeinsam bewegt haben. Wenn ihre Preise auseinanderlaufen – eine steigt, die andere fällt –, würde ein statistischer Arbitrageur die besser laufende Aktie leerverkaufen und die schwächere kaufen, in der Erwartung, dass der „Spread“ zwischen beiden schließlich wieder konvergiert.
Spread – die Preisdifferenz bzw. Diskrepanz zwischen zwei verwandten Finanzinstrumenten.
In der statistischen Arbitrage bezeichnet der Begriff „Spread“ in der Regel die Preisdifferenz bzw. Diskrepanz zwischen zwei verwandten Finanzinstrumenten. Das können zwei verschiedene Aktien, Futures-Kontrakte, Forex-Paare oder sogar Kryptowährungs-Token sein.
So kann man beispielsweise mit einer Software für Pair-Trading-Strategien (einer gängigen Form der statistischen Arbitrage) den Spread zwischen zwei historisch kointegrierten Aktien verfolgen. Weicht der Spread, also die Differenz ihrer Preise, deutlich von seinem historischen Mittelwert (Durchschnitt) ab, signalisiert dies eine Handelsgelegenheit.
Angenommen, der Spread weitet sich zu stark aus, was darauf hindeutet, dass eine Aktie gemessen an ihrer historischen Beziehung überbewertet und die andere unterbewertet ist. In diesem Fall kann ein Trader die überbewertete Aktie leerverkaufen und die unterbewertete kaufen. Verengt sich der Spread dagegen übermäßig, würde er umgekehrt vorgehen.
In der statistischen Arbitrage wird erwartet, dass der Spread zum Mittelwert zurückkehrt, d. h. um einen langfristigen Durchschnittswert schwankt. Trader gehen davon aus, dass der Spread nach einer deutlichen Abweichung von diesem Mittelwert schließlich zu ihm zurückkehrt, sodass sie von dieser Rückkehr profitieren können.
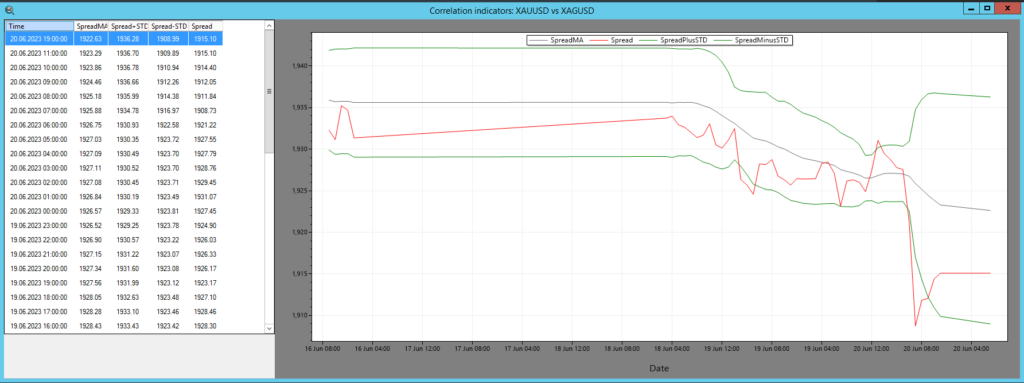
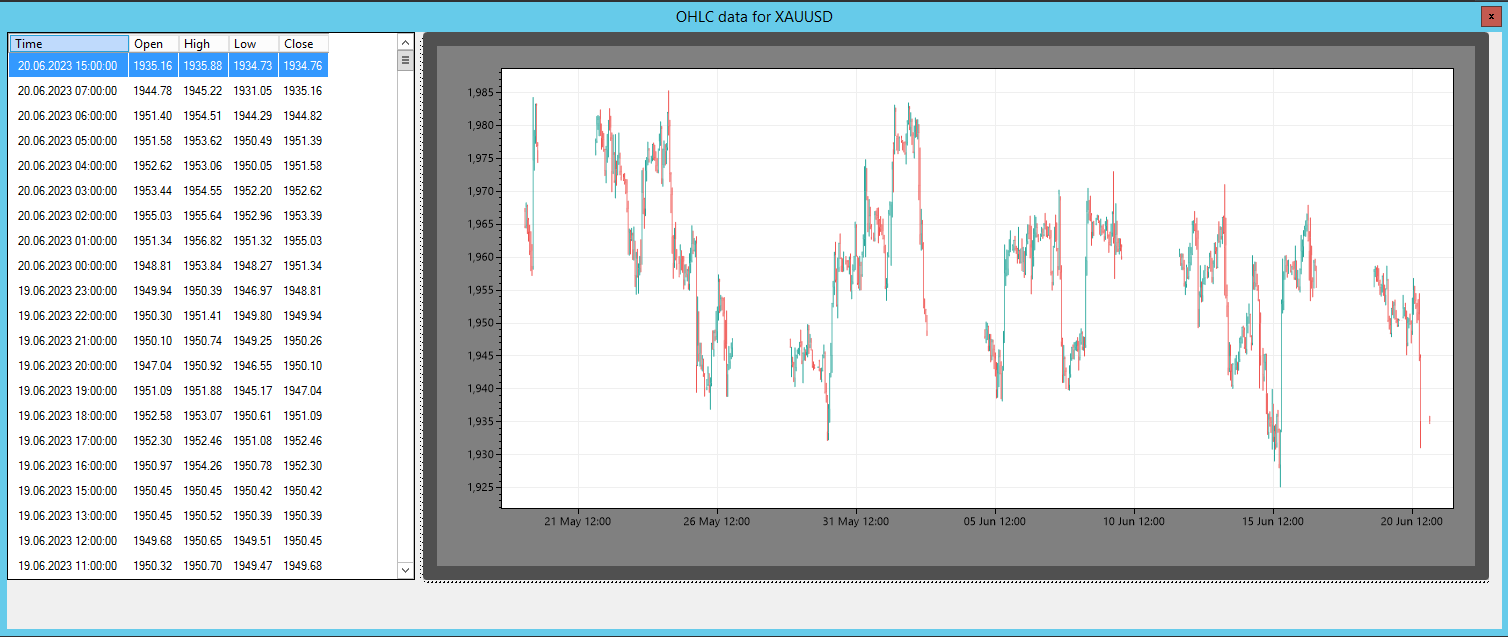
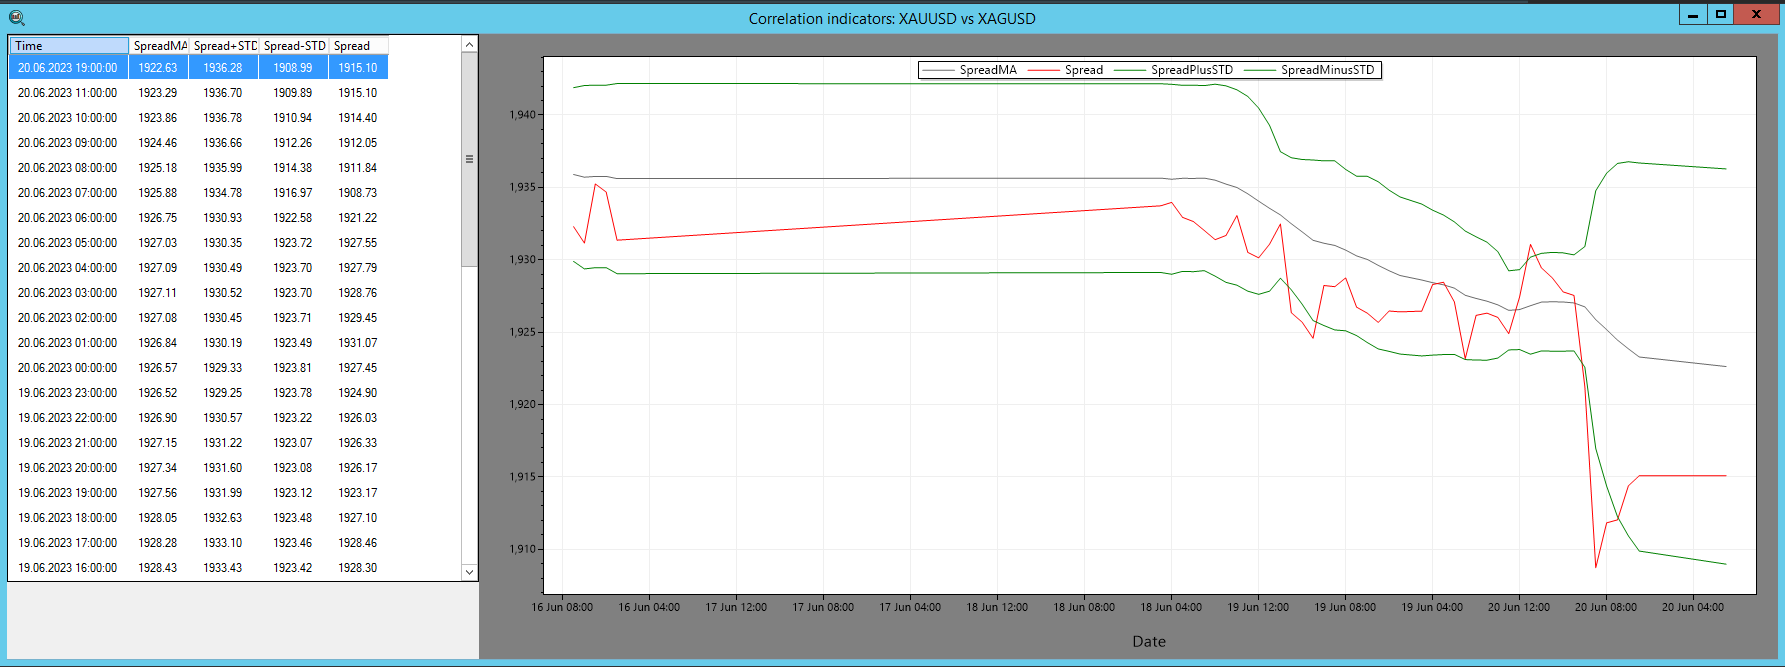
Abb. 1 – Spread-Indikator von SharpTrader™
In der Arbitrage-Software SharpTrader™ wird der Spread-Indikator verwendet, um die Korrelation zwischen zwei Assets zu visualisieren. Die Berechnung der Korrelation umfasst folgende Komponenten:
- Spread: die numerische Differenz bzw. der Abstand zwischen den Werten zweier Assets.
- SpreadMA: der gleitende Durchschnitt des Spreads über einen bestimmten Zeitraum, festgelegt durch pi_SpreadMA_Period.
- STD (Standardabweichung): berechnet die klassische Standardabweichung des Spreads relativ zu SpreadMA. Die Anzahl der verwendeten Beobachtungen entspricht pi_SpreadMA_Period.
Für das Auslösen der Trade-Eröffnung folgt die Software den Prinzipien der Theorie der statistischen Arbitrage.
Ein wenig Theorie zur Korrelationsberechnung
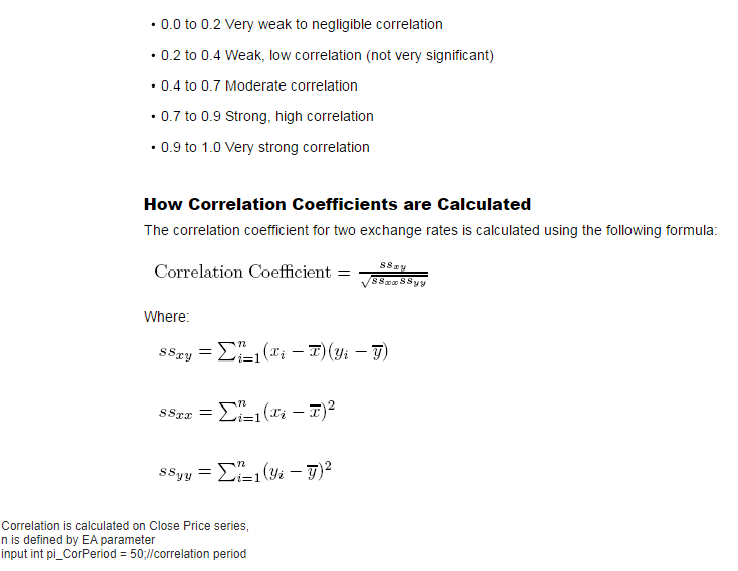
Statistische Arbitrage – Korrelationsmatrix
Eine Korrelationstabelle, auch Korrelationsmatrix genannt, ist eine Tabelle, die die Korrelationskoeffizienten zwischen vielen Variablen zeigt. Jede Zelle der Tabelle zeigt die Korrelation zwischen zwei Variablen. Der Wert liegt im Bereich von -1 bis 1.
Haben zwei Variablen eine Korrelation von 1, bewegen sie sich in dieselbe Richtung, d. h. steigt die eine, steigt auch die andere und umgekehrt. Dies wird als perfekte positive Korrelation bezeichnet.
Haben zwei Variablen eine Korrelation von -1, bewegen sie sich in entgegengesetzte Richtungen, d. h. steigt die eine Variable, fällt die andere und umgekehrt. Dies wird als perfekte negative Korrelation bezeichnet. Eine Korrelation von 0 bedeutet, dass zwischen den Variablen kein Zusammenhang besteht.
Hier ein einfaches Beispiel einer Korrelationstabelle für drei Variablen: A, B und C:
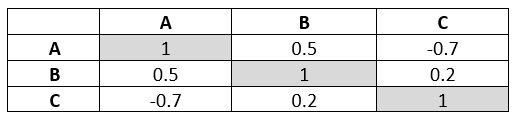
Abb. 2 – Beispiel einer Korrelationstabelle
In dieser Tabelle beträgt die Korrelation zwischen den Variablen A und B 0.5 (eine moderate positive Korrelation), während die Korrelation zwischen A und C -0.7 beträgt (eine starke negative Korrelation). Die Diagonale der Matrix von links oben nach rechts unten ist immer 1, da eine Variable perfekt mit sich selbst korreliert.
Solche Tabellen werden in vielen Bereichen verwendet, auch im Finanzwesen, wo sie helfen, die Beziehung zwischen verschiedenen Finanzvariablen oder den Renditen verschiedener Assets zu bestimmen – nützlich für Portfoliodiversifikation und Risikomanagement.
Eine solche Korrelationsmatrix lässt sich in der Regel mit Statistiksoftware oder Programmiersprachen wie Python oder R erstellen. So geht es auf einfache Weise mit Python und den Bibliotheken pandas und numpy:
import pandas as pd
import numpy as np
# Angenommen, die historischen Daten liegen in zwei Listen vor
crude_oil_prices = […]
texas_oil_prices = […]
# Einen DataFrame erstellen
df = pd.DataFrame({‚Crude Oil‘: crude_oil_prices, ‚Texas Oil‘: texas_oil_prices})
# Die Korrelationsmatrix berechnen
correlation_matrix = df.corr()
print(correlation_matrix)
Dieses Skript gibt eine 2×2-Korrelationsmatrix mit den Korrelationskoeffizienten zwischen den Preisen von Rohöl und texanischem Öl aus.
Umsetzung der statistischen Arbitrage-Strategie
Die Umsetzung statistischer Arbitrage ist eine komplexe Aufgabe. Sie erfordert ausgefeilte statistische Werkzeuge und Modelle, schnelle Rechensysteme und fortschrittliche Algorithmen. Der Ansatz umfasst:
- Paarauswahl: Der erste Schritt besteht darin, Paare von Assets zu identifizieren, die historisch korreliert sind. Dies geschieht in der Regel mit statistischen Methoden wie Kointegrationstests.
- Festlegung der Schwellenwerte: Anschließend legen Trader obere und untere Schwellenwerte für die Abweichung fest. Weichen die Asset-Preise über diese Schwellen hinaus ab, wird ein Handelssignal ausgelöst.
- Trade-Ausführung: Wird ein Handelssignal ausgelöst, führt der Trader die Trades aus: Er kauft das schwächere Asset und verkauft das stärkere leer.
- Trade-Ausstieg: Wenn die Preise der beiden Assets konvergieren (d. h. der Spread zum Mittelwert zurückkehrt), werden die Positionen geschlossen.
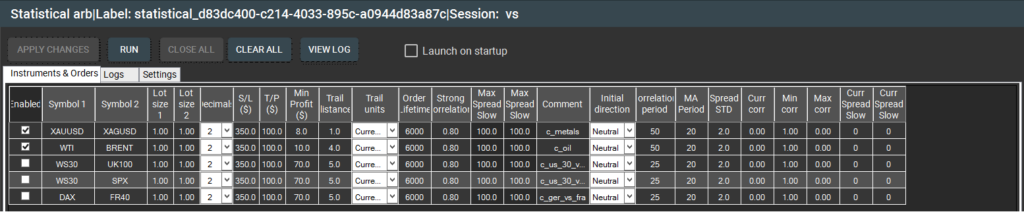
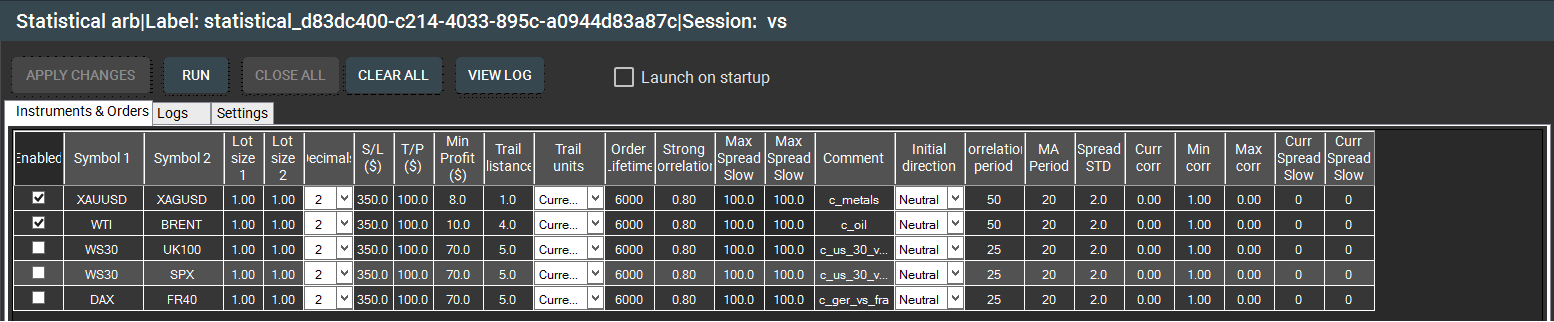
Abb. 3 – Fenster „Instruments & Orders“ der integrierten Strategie für statistische Arbitrage in SharpTrader™.
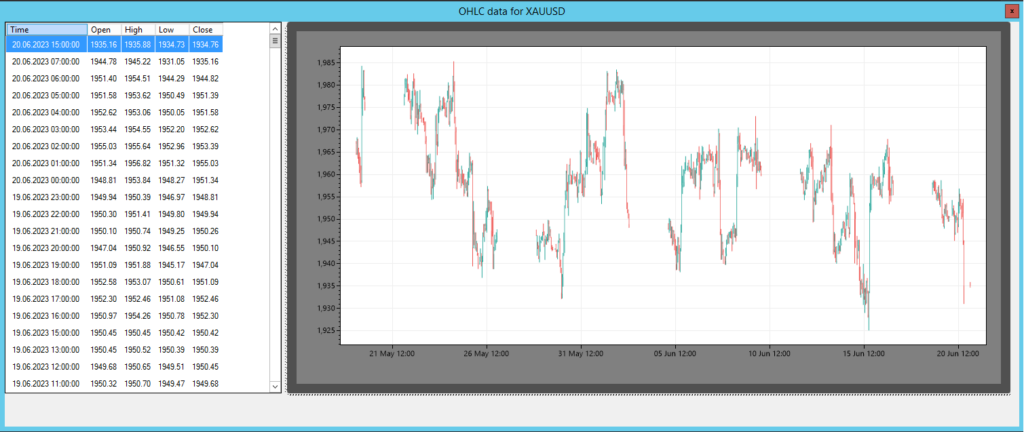
Abb. 4 – Kurse und Grafiken der statistischen Arbitrage in SharpTrader™
Risiken und Einschränkungen
Wie jede Handelsstrategie ist auch die statistische Arbitrage nicht ohne Risiko. Eines der größten Risiken ist das „Modellrisiko“ – die Möglichkeit, dass die mathematischen Modelle auf ungültigen Annahmen beruhen.
Zudem hängt der Erfolg der Strategie stark von der Ausführungsgeschwindigkeit ab, da Preisineffizienzen innerhalb von Millisekunden verschwinden können. Diese Abhängigkeit von Geschwindigkeit macht den Ansatz eher für algorithmische Handelssysteme als für einzelne Trader geeignet.
Die Zukunft der statistischen Arbitrage
Da die Finanzmärkte immer effizienter und automatisierter werden, liegt die Zukunft der statistischen Arbitrage in der Entwicklung ausgefeilterer Algorithmen und Modelle, im maschinellen Lernen und in der künstlichen Intelligenz. Mit dem anhaltenden Tempo technologischer Innovation wird sich auch die statistische Arbitrage weiterentwickeln.
Zusammenfassend bietet die statistische Arbitrage mit ihren komplexen mathematischen Modellen und ihrer Abhängigkeit von schneller Ausführung einen technologisch fortschrittlichen Ansatz für das Trading. Trotz der Herausforderungen und Risiken bleibt sie aufgrund ihres Potenzials für beständige Renditen bei sorgfältigem Risikomanagement eine attraktive Strategie.
Der Einsatz künstlicher Intelligenz (KI) in der statistischen Arbitrage hat neue Möglichkeiten eröffnet, Handelsstrategien zu verbessern und ihre Prognosegenauigkeit zu erhöhen. Maschinelles Lernen, ein Teilbereich der KI, ist besonders nützlich, um komplexe Muster zu erkennen und auf Basis großer Datensätze Prognosen zu erstellen. So können Sie KI für statistische Arbitrage nutzen:
Datenerhebung: Sammeln Sie historische Kursdaten der Finanzinstrumente, die Sie interessieren. Diese Daten können Eröffnungs-, Hoch-, Tief- und Schlusskurse sowie Handelsvolumina umfassen. Sie können auch relevante makroökonomische Daten wie Zinssätze oder BIP-Zahlen einbeziehen, sofern diese für die gehandelten Assets als bedeutsam gelten.
Feature Engineering
Erstellen Sie aus diesen Daten eine Reihe von Merkmalen (Eingangsvariablen) für Ihr KI-Modell. Dazu kann die Berechnung technischer Indikatoren wie gleitender Durchschnitte oder des RSI gehören oder die Bildung von Variablen, die die Preisdifferenz oder das Preisverhältnis zwischen Asset-Paaren abbilden.
Modelltraining
Speisen Sie diese Merkmale in ein Machine-Learning-Modell ein, etwa ein neuronales Netz oder eine Support Vector Machine, um künftige Kursbewegungen oder den Spread zwischen Ihren Assets vorherzusagen. Das Modell lernt aus den Mustern in Ihren historischen Daten.
Modellvalidierung
Validieren Sie die Leistung Ihres Modells mit Out-of-Sample-Daten. Diese nicht im Training verwendeten Daten geben Ihnen ein besseres Verständnis dafür, wie sich Ihr Modell im Live-Handel verhalten wird.
Handelssignale: Nutzen Sie das Modell, um Handelssignale zu erzeugen. Sagt das Modell beispielsweise eine Verengung des Spreads zwischen zwei Assets voraus, könnten Sie das schwächere Asset kaufen und das stärkere leerverkaufen.
Risikomanagement
Halten Sie stets eine Risikomanagementstrategie bereit. KI-Modelle sind wie alle Handelsstrategien nicht perfekt und können falsche Vorhersagen treffen. Es ist entscheidend, das Risiko pro Trade zu begrenzen und Stop Losses zu setzen.
Modellaktualisierung
Überwachen Sie die Leistung Ihres Modells kontinuierlich und aktualisieren Sie es mit neuen Daten. Die Finanzmärkte sind dynamisch, und ein Modell, das in der Vergangenheit gut funktioniert hat, muss dies in Zukunft nicht immer tun. Regelmäßige Aktualisierungen und Anpassungen sind entscheidend, um die Leistung des Modells zu erhalten. Denken Sie daran: KI kann Ihre Handelsstrategie verbessern, ist aber kein Allheilmittel und garantiert keinen Erfolg.
Mehr über die Arbitrage-Software SharpTrader™ erfahren
Statistische Arbitrage – FAQ
F: Wie gleicht man Lotgrößen bei der statistischen Arbitrage aus?
A: Ausgleich der Lotgrößen: Indizes vs. Spots
Bei der statistischen Arbitrage ist es – wie beim Pair Trading – unerlässlich, die Lotgrößen der beteiligten Instrumente richtig aufeinander abzustimmen, insbesondere beim Handel mit Indizes und Metallen. Der Grund liegt darin, dass sich die Kontraktspezifikationen – etwa Kontraktgröße, Kontraktwährung und minimale Lotgröße – häufig von Instrument zu Instrument unterscheiden.
Betrachten wir beispielsweise den Handel von US30 Spot gegen US30 Futures. Laut Spezifikation beträgt die Kontraktgröße für das Spot-Instrument 1, für den Futures-Kontrakt 10. Die minimale Lotgröße beträgt 1 für den Spot und 0.1 für den Future. Eröffnen wir also eine Position von 1 Lot im Spot, muss die entsprechende Position im Future 10-mal kleiner sein, also 0.1 Lots.
Der umgekehrte Fall zeigt jedoch eine Einschränkung: Wollten wir 0.1 Lots im Spot handeln, läge die berechnete äquivalente Position im Future bei 0.01 Lots. Da dieser Wert unter der für den Futures-Kontrakt festgelegten minimalen Lotgröße von 0.1 liegt, wäre eine solche Trade-Konfiguration nicht umsetzbar.
Dieses Beispiel verdeutlicht, wie wichtig es ist, die Kontraktspezifikationen sorgfältig zu prüfen und die Lotgrößen richtig abzustimmen, um Ausgewogenheit und Gültigkeit von Strategien der statistischen Arbitrage zu gewährleisten.
Ausgleich der Lotgrößen bei Instrumenten mit unterschiedlichen Preisen
Beim Handel statistischer Arbitrage zwischen Instrumenten mit unterschiedlichen Preisen, zum Beispiel Gold (XAUUSD) und Silber (XAGUSD), wird die Abstimmung der Lotgrößen noch wichtiger, da sich nicht nur die Kontraktgrößen, sondern auch die absoluten Preisniveaus der Instrumente deutlich unterscheiden.
Schritt 1: Kontraktspezifikationen prüfen.
Nehmen wir an, der Broker legt Folgendes fest:
- XAUUSD (Gold): Kontraktgröße = 100 Feinunzen, Mindestlot = 0.01.
- XAGUSD (Silber): Kontraktgröße = 5,000 Feinunzen, Mindestlot = 0.1.
Schritt 2: Preisniveaus vergleichen.
Angenommen, die aktuellen Preise lauten:
- Gold = 2,500 USD/oz
- Silber = 30 USD/oz
Schritt 3: Nominalwert pro Lot berechnen.
- 1 Lot Gold = 100 × 2,500 = 250,000 USD
- 1 Lot Silber = 5,000 × 30 = 150,000 USD
Schritt 4: Verhältnis bestimmen.
Um die Exposures auszugleichen, müssen wir die Nominalwerte angleichen.
Lot-Verhältnis=250,000/150,000=1.67
Das bedeutet, dass 1 Lot Gold gemessen am Nominalwert etwa 1.67 Lots Silber entspricht.
Schritt 5: Auf kleinere Positionen anwenden.
- Eröffnen wir 0.1 Lot Gold (25,000 USD), läge die entsprechende Silberposition bei 0.167 Lot.
- Da die minimale Lotgröße für Silber jedoch 0.1 beträgt, ist dies umsetzbar.
Fazit:
Beim Aufbau eines Arbitrage-Paares zwischen XAUUSD und XAGUSD müssen sowohl die Kontraktspezifikationen als auch die Preisunterschiede berücksichtigt werden. Der richtige Ansatz besteht darin, den Nominalwert pro Lot zu berechnen und die Positionen anschließend proportional zu skalieren.

