Trading crypto à faible latence : localisation des serveurs des exchanges, latence API réelle et où héberger votre bot novembre 7, 2026 – Posted in: Arbitrage Software, cryptoarbitrage software
Trading crypto à faible latence : localisation des serveurs des exchanges, latence API réelle et où héberger votre bot
Un bot d’arbitrage crypto peut avoir un bon signal et perdre quand même la transaction, car le temps que son ordre atteigne l’exchange, le prix qu’il a vu a déjà disparu. Ce guide explique où les principaux exchanges exécutent réellement leurs moteurs d’appariement, pourquoi un ping vers un hôte API ne vous apprend presque rien, ce que nous avons mesuré depuis un vrai serveur, comment mesurer correctement la latence depuis votre propre machine et comment choisir une région d’hébergement lorsque votre stratégie opère sur deux exchanges situés dans des pays différents.
- Ce que signifie la faible latence dans le trading crypto
- Le budget de latence : où partent les millisecondes
- Où les exchanges crypto exécutent leurs moteurs d’appariement
- Le piège du CDN : pourquoi le ping ment
- Ce que nous avons mesuré depuis un serveur à Montréal
- Étape par étape : mesurer correctement la latence d’un exchange
- Données de marché WebSocket et synchronisation d’horloge
- Choisir une région d’hébergement pour l’arbitrage entre deux exchanges
- Comment la latence se transforme en argent
- Colocation, VPS et ce qui est réaliste pour les traders indépendants
- La latence dans votre propre logiciel
- Risques et limites
- Questions fréquentes
Ce que signifie la faible latence dans le trading crypto
Réponse courte : le trading crypto à faible latence consiste à réduire le temps qui s’écoule entre un changement de prix sur un exchange et l’arrivée de votre ordre au moteur d’appariement de cet exchange. L’essentiel de ce temps est dû à la distance physique : les principaux exchanges exécutent leurs moteurs dans des régions cloud précises, surtout à Tokyo, Singapour et Hong Kong, et un bot hébergé sur un autre continent a 150 à 250 millisecondes de retard sur un bot hébergé à côté du moteur. La deuxième part la plus importante est une surcharge évitable : connexions froides, interrogation REST (polling), horloge mal synchronisée et code lent.
Sur le forex, la latence est une histoire de quelques data centers bien connus à Londres, New York et Tokyo, et de ponts de liquidité des courtiers. En crypto, le tableau est différent. Il n’existe pas de campus d’échange commun : chaque exchange choisit sa propre région cloud, la plupart s’appuient sur une infrastructure cloud publique, et leurs API sont généralement placées derrière des réseaux de diffusion de contenu (CDN) qui donnent l’impression que l’exchange est proche alors qu’il ne l’est pas. La mesure devient ainsi à la fois plus facile (vous pouvez louer un serveur dans la même région cloud pour le prix d’un dîner) et plus trompeuse (les tests évidents mesurent la mauvaise chose).
L’importance de la latence dépend de la stratégie :
| Stratégie | Durée de vie habituelle de l’opportunité | Latence "suffisante" |
|---|---|---|
| Arbitrage inter-exchanges avec transferts entre exchanges | Minutes (limitées par les confirmations blockchain) | Secondes ; les frais et les délais de transfert comptent bien davantage |
| Arbitrage de taux de financement et de base spot-futures | Heures à jours | Non critique ; la qualité d’exécution compte plus que la vitesse |
| Arbitrage de couverture (deux jambes) avec soldes préalablement déposés sur les deux exchanges | Centaines de millisecondes à secondes sur les paires mid-cap, moins sur les majeures | Dizaines de millisecondes vers chaque exchange |
| Arbitrage de latence contre une plateforme plus lente, en concurrence avec les teneurs de marché | Millisecondes | Quelques millisecondes (un chiffre) vers la plateforme tradée, même région cloud |
Si votre avantage provient d’écarts structurels lents, comme l’arbitrage de taux de financement ou les transferts limités par les frais de retrait et les délais de confirmation réseau, vous n’avez besoin de rien d’autre dans ce guide qu’un serveur stable. Si vous tradez des différences de prix entre carnets d’ordres, c’est la différence entre être exécuté et courir après le prix.
Le budget de latence : où partent les millisecondes
La "latence" n’est pas un chiffre unique. Un ordre qui réagit à un mouvement de marché traverse une chaîne d’étapes, et chaque étape ajoute du temps. Raisonner en termes de budget vous indique quelles parties vous pouvez modifier et lesquelles vous échappent.
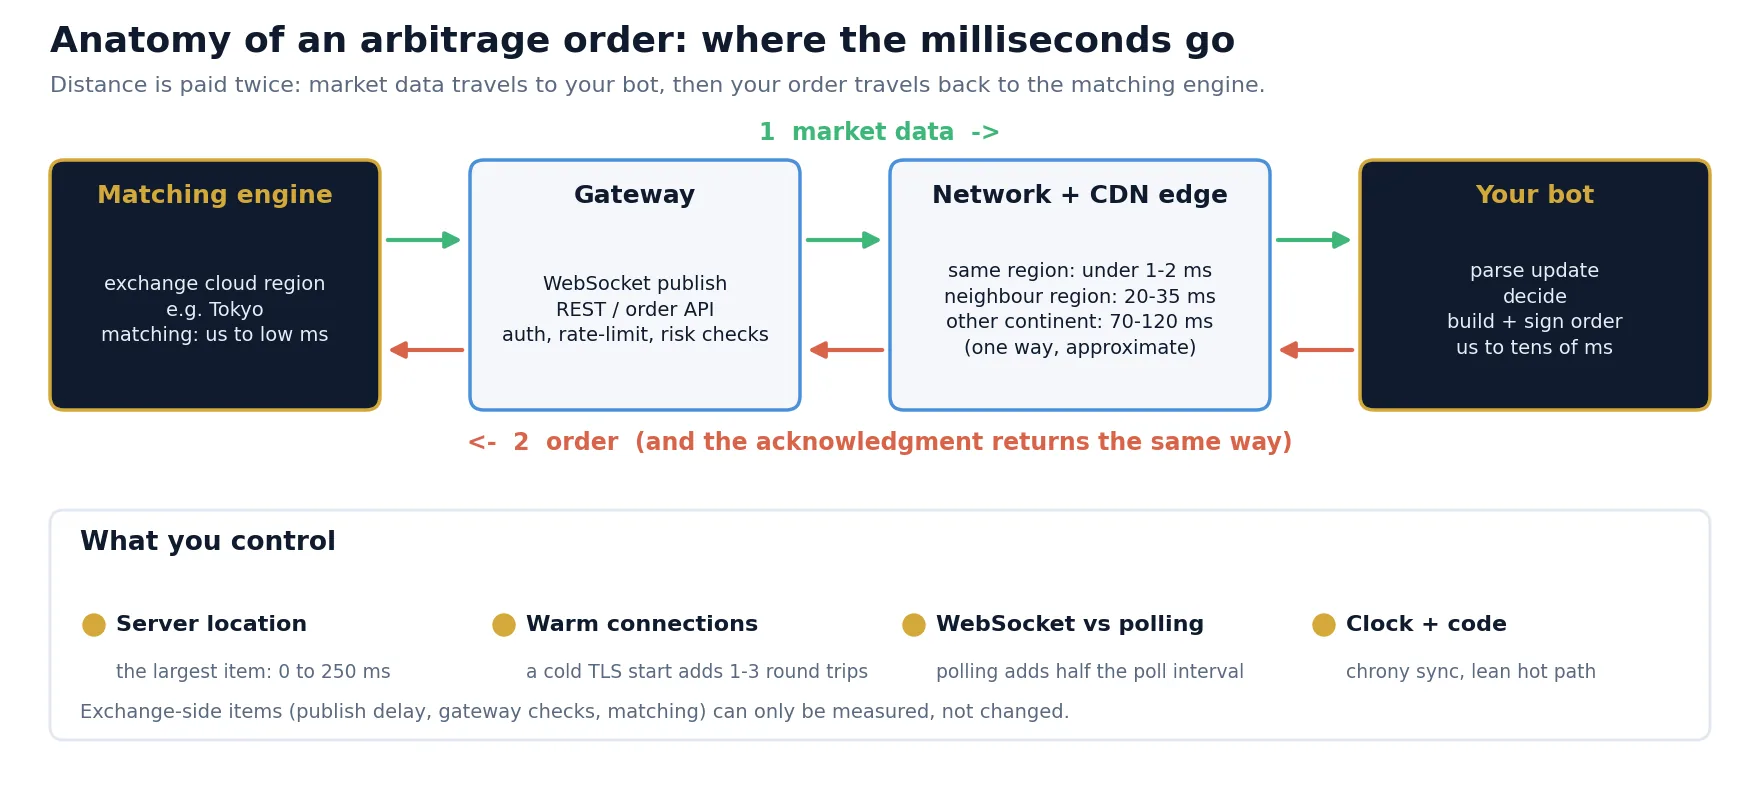
| Composant | Plage typique (approximative) | Qui le contrôle |
|---|---|---|
| Publication des données de marché (du moteur à la passerelle WebSocket) | De moins d’une milliseconde à plusieurs millisecondes ; davantage pour les flux agrégés ou bridés | L’exchange ; vous choisissez le type de flux |
| Réseau, aller simple, même région cloud | Moins de 1 ms à environ 2 ms | Vous, via le choix d’hébergement |
| Réseau, aller simple, régions asiatiques voisines (p. ex. Tokyo vers Hong Kong) | Environ 20 à 35 ms | Vous |
| Réseau, aller simple, entre continents (p. ex. Europe ou Amérique du Nord vers Tokyo) | Environ 70 à 120 ms | Vous |
| Établissement de connexion (handshakes TCP et TLS) sur une connexion froide | Un à trois allers-retours réseau supplémentaires | Vous : maintenez les connexions chaudes |
| Votre propre code de décision | Microsecondes à dizaines de millisecondes | Vous |
| Passerelle API, authentification, limites de débit et contrôles de risque | Quelques millisecondes à quelques dizaines de millisecondes, avec des pics sur les marchés volatils | L’exchange |
| Appariement | Microsecondes à quelques millisecondes | L’exchange |
Le schéma est clair : les deux éléments que vous contrôlez et qui se mesurent en dizaines ou centaines de millisecondes sont l’emplacement de votre serveur et l’état chaud de vos connexions. Tout le reste appartient soit à l’exchange, soit reste faible lorsque le logiciel est écrit de manière raisonnable. C’est pourquoi la suite de ce guide se concentre sur l’emplacement et la mesure.
Où les exchanges crypto exécutent leurs moteurs d’appariement
Les exchanges publient rarement l’emplacement exact de leurs moteurs d’appariement, mais la plupart fonctionnent sur un cloud public, et la région peut être déduite de mesures de latence effectuées depuis de nombreuses régions cloud. Les mesures indépendantes publiées par des tiers en 2026 concordent pour la plupart des grandes plateformes. Le tableau résume les régions rapportées publiquement. Considérez-le comme un point de départ pour vos propres tests, et non comme une garantie : les exchanges migrent (BitMEX, par exemple, aurait déplacé son moteur de Dublin à Tokyo en 2025).
| Exchange | Région du moteur rapportée publiquement | Région cloud à tester en premier | Fiabilité |
|---|---|---|---|
| Binance | Tokyo | AWS ap-northeast-1 | Élevée : cohérente entre mesures indépendantes |
| Bybit | Singapour | AWS ap-southeast-1 | Élevée |
| OKX | Hong Kong | AWS ap-east-1 | Élevée |
| Gate.io, KuCoin, Bitget, HTX | Tokyo | AWS ap-northeast-1 | Moyenne à élevée |
| Coinbase (spot) | États-Unis, côte est | AWS us-east-1 | Moyenne : API derrière un CDN, mesurez les accusés de réception des ordres |
| Kraken | Europe | Testez Londres, Dublin et Francfort | Faible : les sources publiées divergent |
| Deribit | Région de Londres | AWS eu-west-2 | Moyenne à élevée |
Deux conclusions pratiques en découlent. Premièrement, Tokyo est ce qui se rapproche le plus d’un hub de trading central pour la crypto : un serveur sur place se trouve à quelques millisecondes de Binance et de plusieurs autres grandes plateformes, à environ 25 ms aller simple de Hong Kong et à environ 35 ms aller simple de Singapour. Deuxièmement, toute stratégie qui associe un exchange asiatique à Coinbase ou à une plateforme européenne subit un plancher physique de 70 à 120 ms aller simple entre les deux moteurs, quoi que vous fassiez avec votre propre serveur.
Héberger un serveur dans un pays donné ne change pas les exchanges que vous êtes autorisé à utiliser. Respectez les conditions d’utilisation de chaque exchange et les règles de votre propre juridiction ; n’utilisez jamais de serveurs ou de VPN pour contourner des restrictions géographiques.
Le piège du CDN : pourquoi le ping ment
L’erreur la plus courante consiste à mesurer la latence avec ping ou avec le temps d’ouverture d’une connexion TCP vers le nom d’hôte de l’API. Presque tous les grands exchanges placent leurs points d’accès REST et WebSocket publics derrière un CDN ou un équilibreur de charge cloud disposant de points de présence (edges) dans le monde entier. Lorsque vous vous connectez à api.binance.com depuis l’Europe ou l’Amérique du Nord, le serveur qui répond à votre handshake TCP est un nœud edge dans une ville proche, et non le moteur d’appariement à Tokyo. Le handshake prend quelques millisecondes ; ensuite, l’edge transmet votre requête via le backbone du fournisseur jusqu’à l’origine réelle, et c’est là que le temps se perd.
Ainsi, un ping de 5 ms vers le nom d’hôte d’un exchange peut coexister avec un temps de requête réel de 150 ms. Les seuls chiffres qui ont un sens sont ceux qui incluent le trajet jusqu’à l’origine : le temps jusqu’au premier octet d’une vraie réponse API sur une connexion déjà ouverte, l’écart entre l’horodatage d’événement de l’exchange et votre heure de réception sur le WebSocket, et le temps entre l’envoi d’un ordre et la réception de son accusé de réception.
Mesuré par BJF Trading Group le 7 novembre 2026 depuis un serveur web à Montréal (Leaseweb), points d’accès publics d’heure serveur, deux séries d’une requête froide plus 20 requêtes chaudes par exchange.
Ce que nous avons mesuré depuis un serveur à Montréal
Pour montrer l’effet avec des chiffres réels plutôt qu’avec des promesses commerciales, nous avons lancé une petite sonde depuis le serveur web qui héberge ce site, à Montréal. Pour huit exchanges, elle a ouvert une connexion, envoyé une requête (froide), puis envoyé 20 requêtes supplémentaires sur la même connexion keep-alive (chaudes), à raison de quatre requêtes par seconde, et a répété l’ensemble deux fois. Le point d’accès utilisé était l’appel public d’heure serveur de chaque exchange, qui ne fait pratiquement aucun travail : le résultat est donc proche du pur temps de transport plus le temps de passerelle.
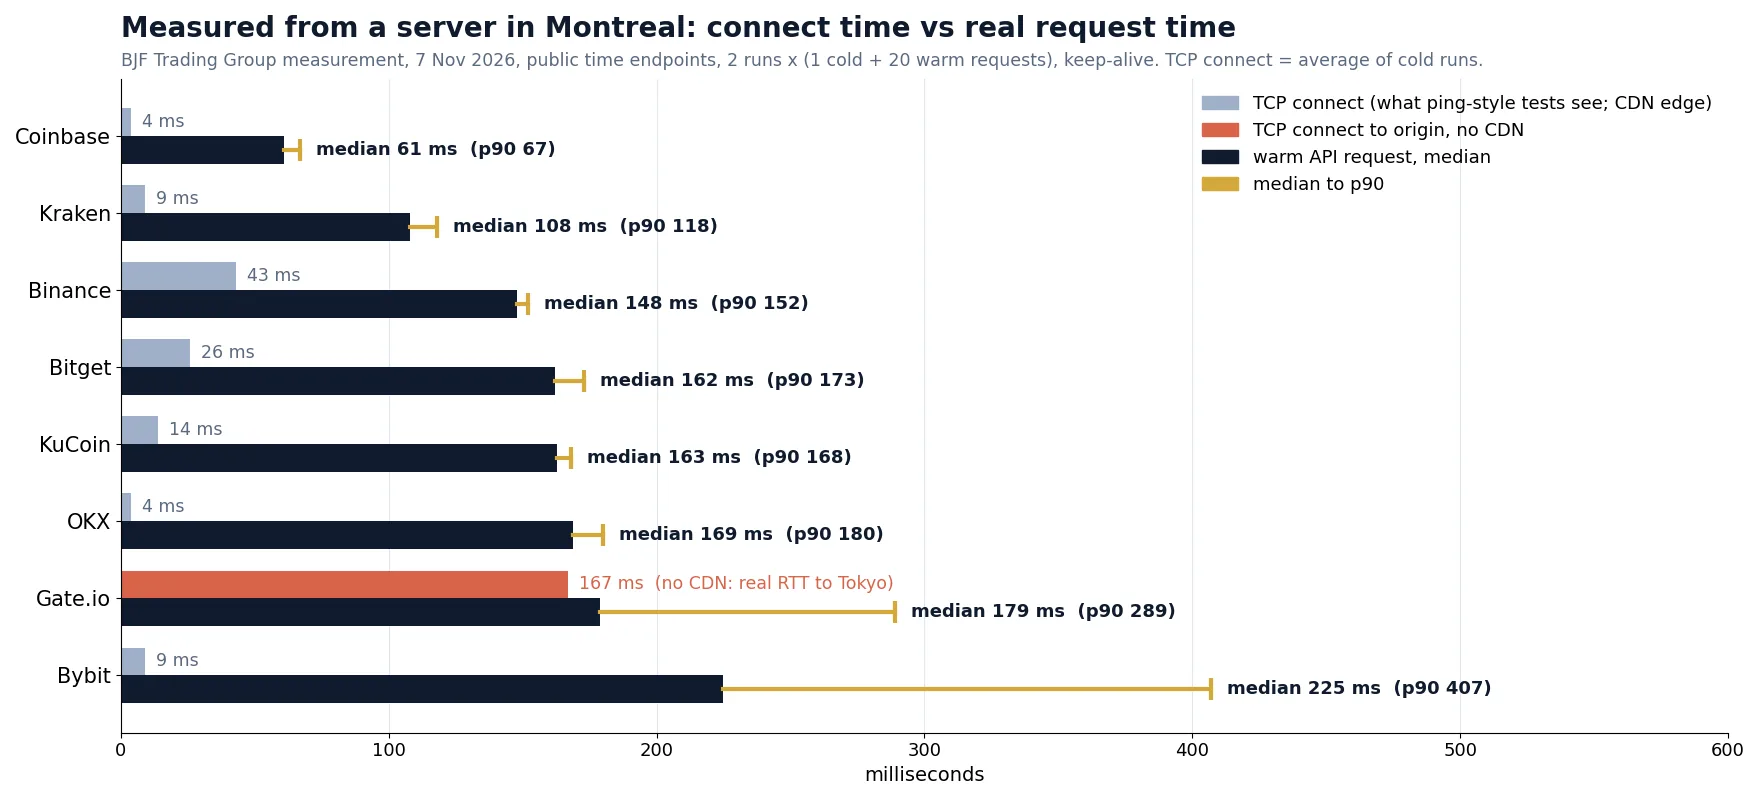
| Exchange | Frontal vu depuis Montréal | Connexion TCP, ms | Première requête froide, ms | Médiane requête chaude, ms | p90 chaud, ms |
|---|---|---|---|---|---|
| Coinbase | Edge Cloudflare | 4 | 119 à 140 | 61 | 67 |
| Kraken | Edge Cloudflare | 3 à 15 | 162 à 179 | 108 | 118 |
| Binance | Edge CloudFront | 11 à 74 | 210 à 277 | 148 | 152 |
| Bitget | Edge Cloudflare | 15 à 37 | 226 à 247 | 162 | 173 |
| KuCoin | Edge Cloudflare | 6 à 23 | 220 à 244 | 163 | 168 |
| OKX | Edge Cloudflare | 3 à 4 | 217 à 232 | 169 | 180 |
| Gate.io | Direct, adresse AWS Tokyo | 167 | 668 à 718 | 179 | 289 |
| Bybit | Edge CloudFront | 8 à 10 | 278 à 281 | 225 | 407 |
Ce petit test fait ressortir quatre enseignements :
- Le temps de connexion ne veut rien dire derrière un CDN. OKX a répondu au handshake TCP en 3 à 4 ms, mais chaque requête réelle a pris environ 170 ms, car le travail s’effectue à Hong Kong.
- Le classement suit la géographie. Coinbase (côte est des États-Unis) est le plus rapide depuis Montréal, Kraken (Europe) arrive deuxième, et les exchanges asiatiques se regroupent entre 150 et 225 ms. Depuis Tokyo, l’ordre serait inversé.
- Les connexions froides coûtent cher. Sans edge à proximité, chaque aller-retour de handshake traverse le Pacifique : la première requête vers Gate.io a pris environ 0.7 seconde, les suivantes environ 0.18 seconde. Un bot qui ouvre une nouvelle connexion au moment où il voit un signal a déjà perdu.
- Les queues de distribution comptent. La médiane de Bybit était de 225 ms, mais une requête sur dix a pris plus de 400 ms. Une jambe d’arbitrage n’est jamais plus rapide que ses cas lents : regardez donc toujours le p90 et le p99, pas seulement la médiane.
Ces chiffres décrivent un serveur web pendant un après-midi, et non une configuration de trading, et ils incluent le traitement par la passerelle de chaque exchange. Ils ne constituent pas un classement des exchanges. Leur but est de montrer l’ordre de grandeur des effets : la géographie et la gestion des connexions représentent plus de 90% du délai subi par un bot éloigné.
Étape par étape : mesurer correctement la latence d’un exchange
Vous pouvez reproduire une mesure pertinente depuis n’importe quel serveur en une heure. La méthode ci-dessous est celle que nous recommandons avant de choisir une région d’hébergement ou après toute modification de votre infrastructure.
Pour l’étape 2, un simple curl suffit pour commencer. En répétant l’URL, curl réutilise une seule connexion ; la première ligne correspond à la requête froide, les suivantes aux requêtes chaudes :
curl -s –rate 4/s -w "%{num_connects} %{time_connect} %{time_starttransfer}\n" -o /dev/null URL -o /dev/null URL -o /dev/null URL
Pour les étapes 4 et 5, il vous faut quelques lignes de code dans le langage de votre bot, car la mesure doit passer par la même bibliothèque cliente, le même parseur JSON et les mêmes paramètres de connexion que le trading réel. Un chiffre produit par un autre outil ne vous renseigne que sur cet outil.
Données de marché WebSocket et synchronisation d’horloge
Pour tout ce qui est sensible au temps, les données de marché doivent provenir de flux WebSocket, et non d’une interrogation REST. Une boucle qui demande le carnet d’ordres toutes les 200 ms ajoute en moyenne 100 ms d’attente avant même de voir un changement, en plus du temps de requête, et elle consomme le budget de limites de débit dont vous avez besoin pour les ordres. Un flux WebSocket pousse chaque mise à jour dès que l’exchange la publie. Les détails des flux, des carnets d’ordres locaux et des contrôles de séquence sont traités dans notre guide sur la connexion aux API des exchanges crypto pour l’arbitrage ; ici, nous nous concentrons sur le timing.
Mesurer le retard du flux
La plupart des messages WebSocket des exchanges contiennent un horodatage fixé par l’exchange : heure de l’événement, heure de la transaction ou heure du message, généralement en millisecondes. Soustrayez-le de votre heure locale de réception et vous obtenez le retard du flux, qui inclut le délai interne de publication de l’exchange et le trajet réseau. Enregistrez-le par flux, et pas seulement en moyenne : les snapshots de profondeur, les mises à jour incrémentales du carnet et les flux de transactions peuvent se comporter différemment, et les flux agrégés publiés toutes les 100 ms présenteront un motif en dents de scie.
Pourquoi l’horloge compte
Les mesures en aller simple ne valent que par la concordance entre votre horloge et celle de l’exchange. Si l’horloge de votre serveur retarde de 15 ms, chaque retard de flux paraîtra meilleur de 15 ms qu’il ne l’est. Sur un serveur cloud, faites tourner chrony avec le service de temps du fournisseur et vérifiez chronyc tracking : un décalage d’environ une milliseconde au plus constitue une base solide pour comparer des régions. De nombreux exchanges exposent aussi un point d’accès d’heure serveur ; le comparer à votre horloge en tenant compte de la moitié de l’aller-retour mesuré permet une vérification approximative. Les points d’accès d’ordres qui acceptent une fenêtre de réception (un âge maximal autorisé pour l’horodatage de la requête) rejetteront également les ordres si votre horloge dérive, ce qui est une raison de plus de la garder synchronisée.
Mesurez le chemin des ordres séparément
Le retard du flux vous indique l’âge de votre vision du marché. L’aller-retour des ordres vous indique combien de temps il faut pour agir en conséquence. Les deux diffèrent souvent : les requêtes d’ordres passent par l’authentification, le décompte des limites de débit et des contrôles de risque qu’un flux de données de marché ne subit pas. Certains exchanges, dont Binance, proposent un point d’accès de test d’ordre qui valide un ordre signé sans l’envoyer au moteur d’appariement ; il mesure la partie réseau et passerelle. Lorsque l’exchange propose le passage d’ordres via une session WebSocket ou FIX, mesurez-la aussi, car une session persistante évite la surcharge propre à chaque requête.
Choisir une région d’hébergement pour l’arbitrage entre deux exchanges
Pour un seul exchange, la réponse est simple : louez un serveur dans la même région cloud que son moteur. L’arbitrage entre deux exchanges est un problème de géométrie, car les moteurs se trouvent à des endroits différents et vous ne pouvez être à côté que de l’un d’eux.
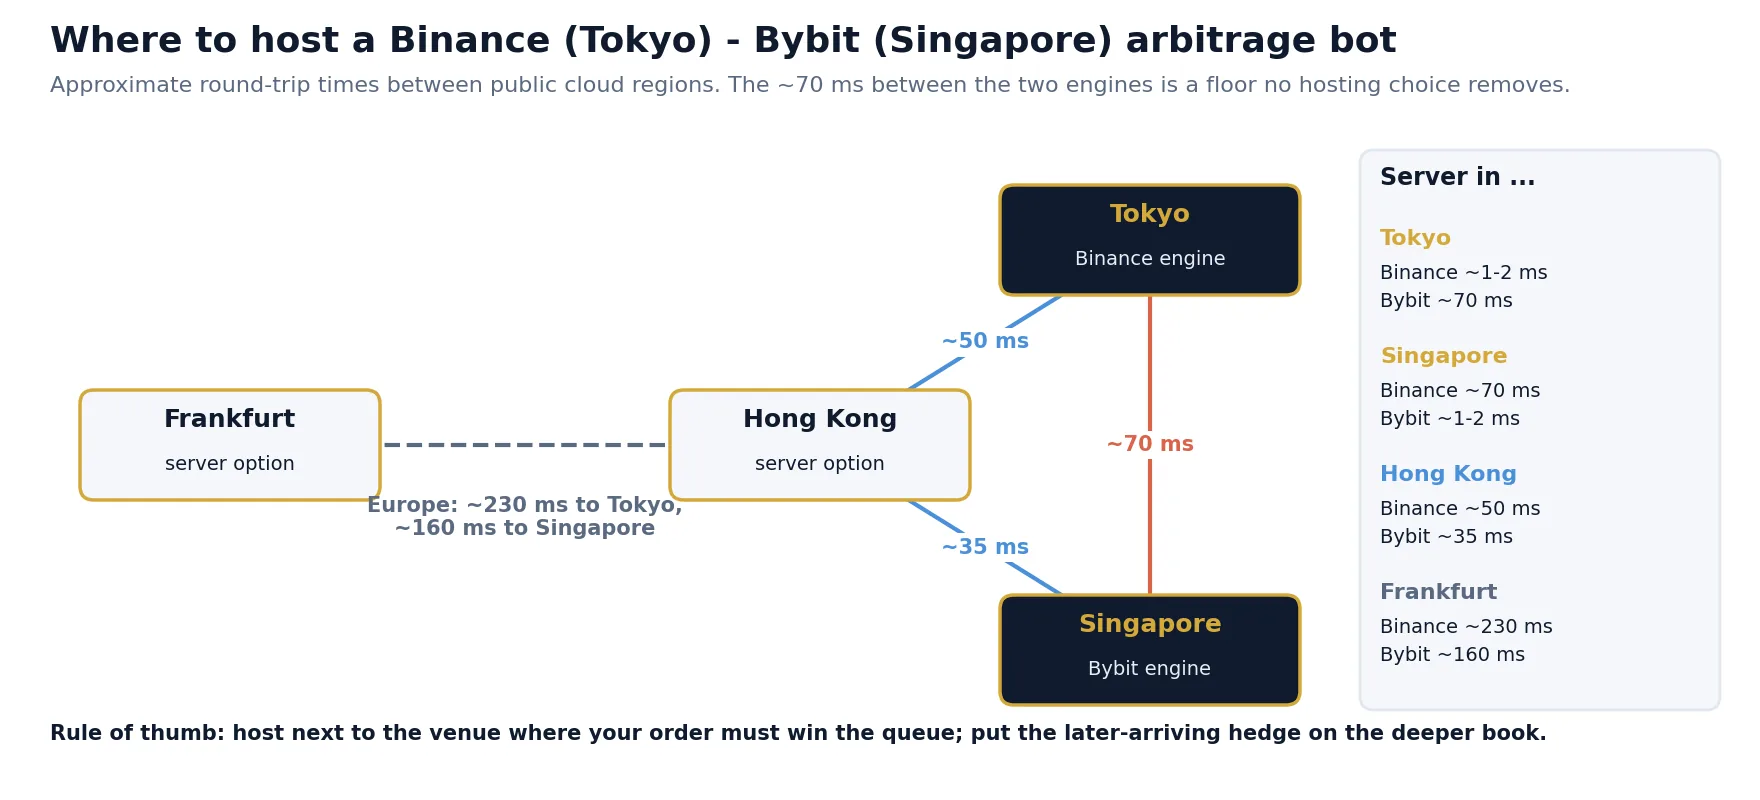
Prenons un arbitrage de couverture entre Binance (Tokyo) et Bybit (Singapour). L’aller-retour entre les deux régions est d’environ 70 ms, soit à peu près 35 ms en aller simple. Examinons les principales options :
| Emplacement du serveur | Aller-retour vers Binance | Aller-retour vers Bybit | Évaluation |
|---|---|---|---|
| Tokyo | Environ 1 à 2 ms | Environ 70 ms | Rapide sur Binance, la jambe Bybit paie toute la distance |
| Singapour | Environ 70 ms | Environ 1 à 2 ms | L’image inverse |
| Hong Kong | Environ 50 ms | Environ 35 ms | Lent sur les deux jambes ; rarement le meilleur choix pour deux plateformes |
| Europe (p. ex. Francfort) | Environ 230 ms | Environ 160 ms | Hors course pour toute stratégie sensible au temps |
Les allers-retours sont des valeurs typiques approximatives entre régions cloud publiques ; vérifiez les chiffres inter-régions actuels de votre fournisseur et mesurez depuis vos propres serveurs.
L’observation clé est que l’information doit toujours franchir la distance entre les deux exchanges. Si le prix bouge sur Binance et que la cotation périmée se trouve sur Bybit, un serveur à Tokyo voit le mouvement immédiatement et son ordre parcourt 35 ms jusqu’à Singapour ; un serveur à Singapour reçoit le mouvement avec 35 ms de retard et son ordre arrive immédiatement. Le total est identique. Ce qui change, c’est quelle partie de la chaîne attend, et donc quel critère doit guider le choix :
- Hébergez à côté de la plateforme où l’ordre doit gagner. Si votre profit dépend de la capacité à toucher une cotation avant les autres traders sur un exchange, placez-vous là où se décide cette file d’attente. Les informations de tout le monde sur l’autre exchange y arrivent à la même vitesse, mais votre ordre n’a pas à voyager.
- Placez la couverture sur le carnet le plus profond. La jambe qui atteint son exchange en dernier doit être celle qui est la moins sensible à quelques millisecondes : le carnet le plus liquide, où le prix de couverture a peu de chances de beaucoup bouger.
- Connaissez rapidement le statut d’exécution. Être à côté de l’exchange où les exécutions partielles sont fréquentes vous permet de dimensionner la couverture sur la base d’informations exactes, ce qui réduit le risque non couvert.
- Ne scindez que si cela rapporte. Deux processus, un par région, peuvent chacun maintenir un carnet d’ordres local et réagir localement, mais ils doivent se coordonner via le même lien de 70 ms. Cela ajoute de la complexité et des modes de défaillance et ne se justifie surtout que pour des configurations professionnelles.
Pour les stratégies portant sur trois plateformes asiatiques ou plus, Tokyo est généralement le centre pratique en raison du nombre de grands exchanges qui s’y trouvent. Pour les paires qui incluent une plateforme américaine ou européenne, la jambe intercontinentale domine et la stratégie doit tolérer 70 à 120 ms en aller simple, ce qui exclut la pure course à la vitesse et favorise des écarts plus larges et plus durables.
Comment la latence se transforme en argent
Une différence de prix entre deux carnets d’ordres n’est pas un gain acquis. D’autres traders la voient aussi, les teneurs de marché mettent à jour leurs cotations, et l’écart disparaît dans un délai qui dépend de l’actif et de la plateforme. Une façon simple d’y réfléchir consiste à supposer que chaque opportunité survit pendant une durée aléatoire avec une durée de vie moyenne, et à se demander quelle est la probabilité qu’elle soit encore là à l’arrivée de votre ordre.
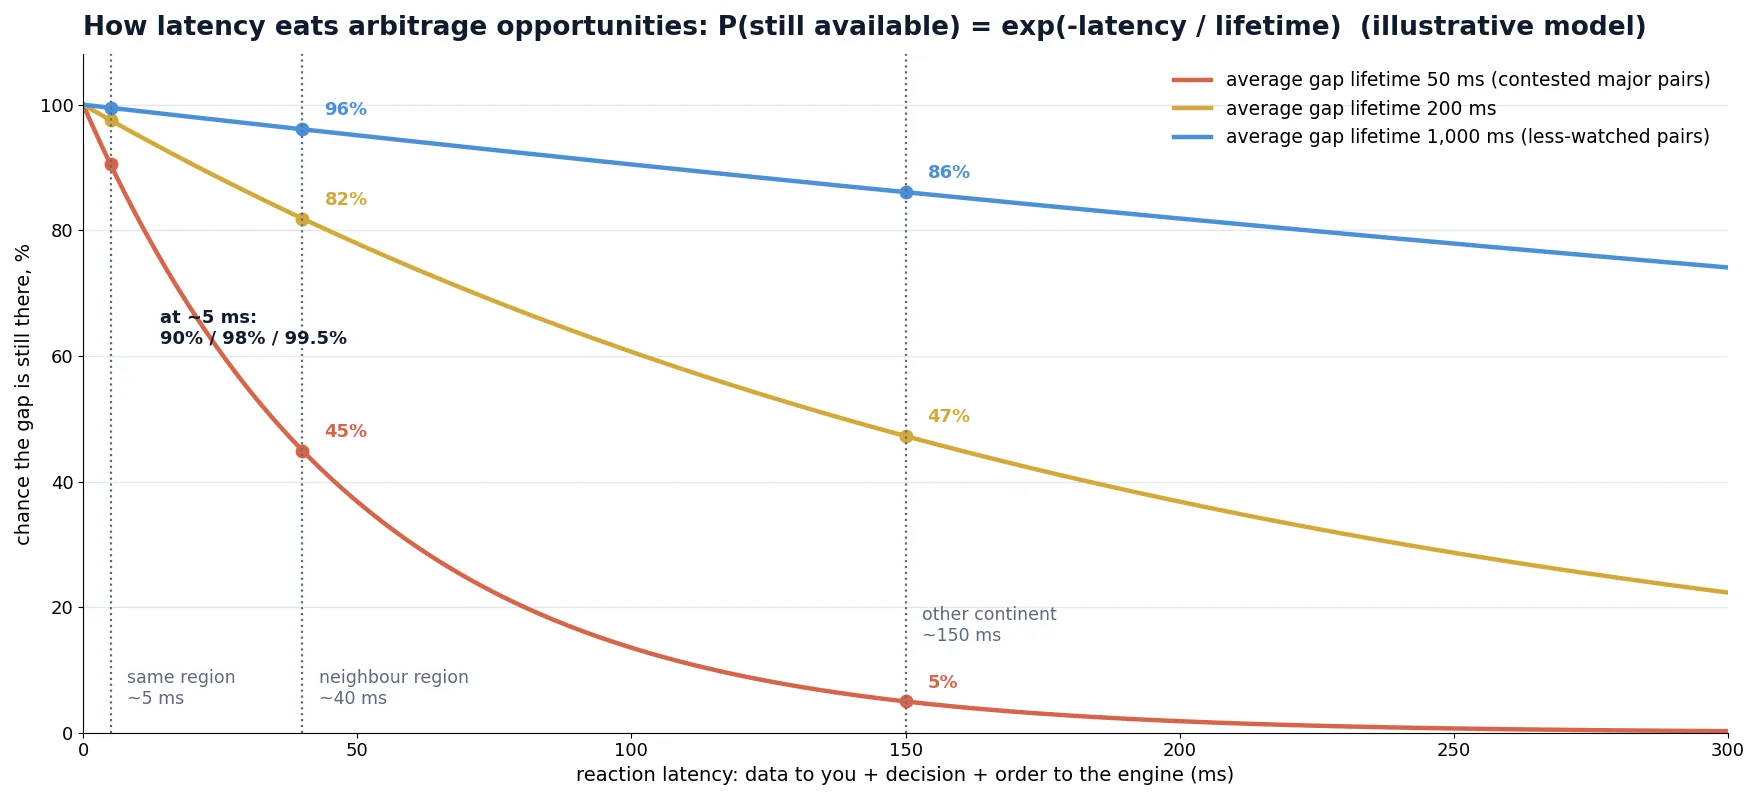
Dans ce modèle, la probabilité qu’un écart soit encore présent après un temps de réaction de L millisecondes est exp(−L / τ), où τ est la durée de vie moyenne de l’écart. Voici les résultats pour trois temps de réaction, qui correspondent approximativement à un serveur dans la même région (5 ms), dans une région voisine (40 ms) et sur un autre continent (150 ms) :
| Durée de vie moyenne de l’écart | Réaction 5 ms | Réaction 40 ms | Réaction 150 ms |
|---|---|---|---|
| 50 ms (écarts disputés sur les paires majeures) | 90% | 45% | 5% |
| 200 ms | 98% | 82% | 47% |
| 1,000 ms (paires moins surveillées) | 99.5% | 96% | 86% |
Associons maintenant de l’argent à ce modèle. Supposons qu’une stratégie trouve 200 signaux par jour avec un avantage net de 0.10% sur une transaction de 5,000 USDT, soit 5 USDT par signal capté, et qu’un signal manqué coûte en moyenne 1.5 USDT, parce qu’une jambe a été exécutée et doit être dénouée. Pour des écarts d’une durée de vie de 200 ms :
| Emplacement du serveur | Capté | Espérance par signal | Par jour (200 signaux) |
|---|---|---|---|
| Même région (5 ms) | 98% | 0.98 × 5 − 0.02 × 1.5 = 4.87 USDT | Environ 974 USDT |
| Région voisine (40 ms) | 82% | 0.82 × 5 − 0.18 × 1.5 = 3.83 USDT | Environ 766 USDT |
| Autre continent (150 ms) | 47% | 0.47 × 5 − 0.53 × 1.5 = 1.56 USDT | Environ 311 USDT |
Les chiffres sont hypothétiques, mais la conclusion est solide : déplacer un bot d’un autre continent vers la bonne région peut multiplier le résultat d’une même stratégie, tandis que passer d’une région voisine à la même région apporte une amélioration plus modeste mais toujours significative. Cela montre aussi la limite : pour des écarts qui durent une seconde ou plus, la latence compte à peine, et ce sont les frais, le slippage et l’inventaire qui décident du résultat. Avant d’investir dans l’infrastructure, vérifiez combien de temps durent réellement les écarts que vous tradez ; le scanner d’arbitrage crypto gratuit vous permet d’observer en direct les différences de prix réelles entre exchanges.
Colocation, VPS et ce qui est réaliste pour les traders indépendants
Sur le forex et les actions, la colocation consiste à louer de l’espace en baie dans le même data center que les serveurs de la bourse ou du courtier, et les principaux hubs sont bien connus (voir notre guide sur les VPS d’arbitrage forex et hubs de colocation). En crypto, l’équivalent pour la plupart des traders est simplement un serveur virtuel dans la même région cloud que l’exchange. Comme le moteur lui-même tourne dans ce cloud, un serveur dans la même région se trouve déjà à une ou deux millisecondes de lui, pour un coût de quelques dizaines de dollars par mois.
| Option | Latence typique vers le moteur | Coût | Pour qui |
|---|---|---|---|
| PC personnel ou connexion de bureau | Dizaines à centaines de ms, instable | Aucun | Surveillance, stratégies lentes, tests |
| VPS dans une autre région ou sur un autre continent | 70 à 250 ms | Faible | Arbitrage de financement, de base et par transferts |
| Serveur cloud dans la région de l’exchange | Environ 1 à 2 ms aller-retour sur le réseau | Faible à modéré | Arbitrage de couverture et la plupart des stratégies particulières sensibles à la latence |
| Même zone de disponibilité, instances optimisées | Gains réseau inférieurs à la milliseconde | Modéré | Équipes professionnelles ayant déjà tout optimisé par ailleurs |
| Connectivité dédiée ou programmes pour teneurs de marché | La plus faible disponible | Élevé, généralement lié aux paliers de volume | Teneurs de marché et institutions |
Au sein d’une région, la zone de disponibilité peut faire une différence supplémentaire d’une fraction de milliseconde. Cela ne compte que lorsque vous êtes en concurrence avec des teneurs de marché professionnels sur les paires les plus liquides, et cela ne vaut la peine d’être testé qu’après avoir réglé les points plus importants : région, connexions chaudes, données WebSocket et votre propre code. Les principes généraux sur la rapidité nécessaire d’un serveur, et sur la raison pour laquelle une faible latence compte davantage que des caractéristiques élevées, sont traités dans quelle vitesse doit avoir votre VPS pour l’arbitrage.
La latence dans votre propre logiciel
Une fois le serveur au bon endroit, les délais restants sont surtout auto-infligés. Les coupables habituels, dans l’ordre où nous les rencontrons :
- Ouvrir des connexions à la demande. Maintenez les connexions REST actives avec un pool de connexions, envoyez périodiquement une requête légère pour que les connexions inactives ne soient pas fermées, et reconnectez les WebSockets de manière proactive avant la durée de session maximale de l’exchange.
- Interroger au lieu de recevoir un flux. Utilisez les données de marché WebSocket et, lorsque c’est possible, la saisie d’ordres via WebSocket ou FIX.
- Un travail lourd sur le chemin critique. Écrire des logs sur disque, analyser de gros messages JSON champ par champ ou recalculer tout le carnet d’ordres à chaque mise à jour ajoutent des millisecondes. Faites le strict minimum avant d’envoyer l’ordre et reportez le reste.
- Pénalités de limites de débit. Un bot qui dépasse la limite de poids des requêtes est rejeté ou temporairement banni, ce qui équivaut à une latence infinie. Budgétez les requêtes par exchange et ralentissez avant la limite, pas après.
- Garbage collection et contention CPU. Sur un petit VPS mutualisé, les autres locataires et les pauses de nettoyage mémoire peuvent ajouter des dizaines de millisecondes à des moments aléatoires. Cela apparaît dans le p99, pas dans les moyennes.
- Envoi séquentiel des jambes. Si les deux jambes d’une couverture sont indépendantes, envoyez-les en parallèle au lieu d’attendre le premier accusé de réception.
Le logiciel VIP Crypto Arbitrage de BJF Trading Group se connecte aux exchanges centralisés spot et futures via leurs API natives et fonctionne sur un serveur que vous choisissez : les principes d’emplacement de ce guide s’y appliquent donc directement. Pour la logique des stratégies fondées sur la latence elles-mêmes, consultez notre guide de l’arbitrage de latence, et pour une vue d’ensemble des stratégies inter-exchanges, la présentation de l’arbitrage crypto.
Risques et limites
- La latence n’est pas un avantage en soi. Être rapide n’aide que si la stratégie est rentable après frais, slippage et coûts d’inventaire. Un bot rapide avec un avantage négatif perd de l’argent plus vite.
- Les emplacements changent. Les exchanges migrent leurs moteurs et changent de fournisseur CDN. Une région pertinente l’an dernier ne l’est peut-être plus aujourd’hui ; refaites les mesures régulièrement.
- Les mesures sont locales. Nos chiffres de Montréal, comme tout tableau publié, décrivent un lieu et un moment. Seules les mesures effectuées depuis votre propre serveur, via votre propre logiciel, sont valables pour vos décisions.
- En période de stress, les délais côté exchange dominent. Sur des marchés violents, les passerelles mettent les requêtes en file d’attente et les accusés de réception ralentissent pour tout le monde. Votre stratégie doit le tolérer, par exemple en limitant la taille des positions lorsque les temps d’accusé de réception augmentent.
- La course aux armements n’a pas de fin. Sur les paires les plus liquides, les sociétés professionnelles investissent bien plus dans la vitesse qu’un trader indépendant ne peut le faire. Cherchez des écarts qui durent assez longtemps pour votre configuration au lieu de rivaliser sur les plus brefs.
- Conformité. L’emplacement du serveur ne change pas votre situation juridique. N’utilisez que les exchanges et produits qui vous sont accessibles, et respectez les conditions des API et les limites de débit.
Vérifiez combien de temps durent les écarts réels avant d’optimiser
Observez les différences de prix réelles entre exchanges centralisés, leur ampleur et la vitesse à laquelle elles se referment. Décidez ensuite quelle latence votre stratégie peut tolérer.
Obtenir le Crypto Arbitrage Scanner gratuitLogiciel VIP Crypto Arbitrage
Scanner d’arbitrage gratuit + mini-cours par e-mail
Recevez le lien du scanner gratuit et quelques e-mails courts et pratiques de Boris : ce que signifie vraiment un écart de prix après les coûts, comment tester une stratégie avant de risquer de l’argent réel et quels outils conviennent à votre marché. Sans promesses exagérées. Les e-mails sont rédigés en anglais.
Questions fréquentes
Qu’est-ce que le trading crypto à faible latence ?
C’est trader avec le délai le plus court possible entre un événement de marché sur un exchange et l’arrivée de votre ordre au moteur d’appariement de cet exchange. En pratique, cela signifie héberger le serveur de trading dans la même région cloud que l’exchange, utiliser des données WebSocket et des connexions chaudes, et garder votre propre code rapide.
Où se trouvent les serveurs de Binance ?
Les mesures de latence indépendantes situent systématiquement le moteur d’appariement de Binance à Tokyo, dans la région AWS ap-northeast-1. Son API publique est placée derrière un CDN : le serveur qui répond à un ping est donc généralement un nœud edge proche de vous ; mesurez les temps réels des requêtes et des ordres pour confirmer.
Le ping est-il un bon moyen de mesurer la latence d’un exchange ?
Non. La plupart des API d’exchanges se trouvent derrière des CDN : les temps de ping et de connexion TCP ne mesurent donc que la distance jusqu’à l’edge le plus proche. Lors de notre test depuis Montréal, OKX a répondu au handshake TCP en 3 à 4 ms, mais chaque requête réelle a pris environ 170 ms. Mesurez plutôt le temps jusqu’au premier octet sur une connexion chaude, le retard du flux et le temps d’accusé de réception des ordres.
Ai-je besoin de colocation pour l’arbitrage crypto ?
Pour la plupart des traders indépendants, non. Comme les principaux exchanges fonctionnent dans des régions cloud publiques, un serveur dans la même région se trouve déjà à une ou deux millisecondes du moteur. Des programmes de connectivité dédiée existent pour les teneurs de marché et les comptes à fort volume, mais ils ne comptent qu’une fois tout le reste optimisé.
Quelle latence est suffisante pour l’arbitrage crypto ?
Cela dépend de la durée des écarts. Les stratégies de taux de financement, de base et par transferts fonctionnent avec des secondes de délai. L’arbitrage de couverture avec des soldes sur les deux exchanges nécessite généralement quelques dizaines de millisecondes vers chaque plateforme. Rivaliser pour les écarts les plus brefs sur les paires majeures exige quelques millisecondes seulement, depuis la même région.
Quelle région est la meilleure pour trader sur plusieurs exchanges crypto ?
Tokyo est généralement le meilleur emplacement unique pour les exchanges asiatiques, car Binance et plusieurs autres grandes plateformes s’y trouvent, et Hong Kong et Singapour sont à environ 25 à 35 ms en aller simple. Si vos exchanges sont répartis sur plusieurs continents, choisissez l’emplacement de la plateforme où vos ordres doivent être les plus rapides.
Le WebSocket est-il plus rapide que REST pour les données de marché crypto ?
Oui, en pratique. Un flux WebSocket pousse chaque mise à jour au moment où l’exchange la publie, tandis que l’interrogation REST ajoute un temps d’attente entre les requêtes plus une requête complète pour chaque vérification, et elle consomme les limites de débit. Utilisez REST principalement pour les snapshots, les requêtes de compte et la reprise après incident.
Cet article est éducatif et ne constitue pas un conseil financier. Les chiffres de latence du tableau de Montréal ont été mesurés par BJF Trading Group le 7 novembre 2026 depuis un seul serveur et ne constituent pas un classement des exchanges ; les informations sur les régions reposent sur des mesures de tiers rapportées publiquement et peuvent évoluer. Les chiffres et graphiques indiqués comme illustratifs ou approximatifs sont des modèles et des valeurs typiques, et non des mesures d’un exchange ou d’un trader en particulier.
