Trading crypto a bassa latenza: dove si trovano i server degli exchange, latenza API reale e dove ospitare il tuo bot Novembre 7, 2026 – Posted in: Arbitrage Software, cryptoarbitrage software
Trading crypto a bassa latenza: dove si trovano i server degli exchange, latenza API reale e dove ospitare il tuo bot
Un bot di arbitraggio crypto può avere un buon segnale e perdere comunque il trade, perché quando il suo ordine raggiunge l’exchange il prezzo che aveva visto è già sparito. Questa guida spiega dove i principali exchange fanno girare davvero i loro motori di matching, perché un ping verso un host API non ti dice quasi nulla, cosa abbiamo misurato da un server reale, come misurare correttamente la latenza dalla tua macchina e come scegliere una regione di hosting quando la tua strategia opera su due exchange in paesi diversi.
- Cosa significa bassa latenza nel trading crypto
- Il budget di latenza: dove vanno i millisecondi
- Dove gli exchange crypto fanno girare i motori di matching
- La trappola della CDN: perché il ping mente
- Cosa abbiamo misurato da un server a Montreal
- Passo dopo passo: misurare correttamente la latenza degli exchange
- Dati di mercato via WebSocket e sincronizzazione dell’orologio
- Scegliere la regione di hosting per l’arbitraggio tra due exchange
- Come la latenza si trasforma in denaro
- Colocation, VPS e cosa è realistico per i trader indipendenti
- La latenza dentro il tuo software
- Rischi e limiti
- Domande frequenti
Cosa significa bassa latenza nel trading crypto
Risposta breve: il trading crypto a bassa latenza consiste nel ridurre il tempo tra una variazione di prezzo su un exchange e l’arrivo del tuo ordine al motore di matching di quell’exchange. Gran parte di questo tempo è distanza fisica: i principali exchange fanno girare i loro motori in specifiche regioni cloud, soprattutto a Tokyo, Singapore e Hong Kong, e un bot ospitato in un altro continente è indietro di 150-250 millisecondi rispetto a un bot ospitato accanto al motore. La seconda parte più grande è un overhead evitabile: connessioni fredde, polling REST, un orologio mal sincronizzato e codice lento.
Nel forex la latenza è una storia di pochi data center ben noti a Londra, New York e Tokyo e dei bridge di liquidità dei broker. Nel mondo crypto il quadro è diverso. Non esiste un campus di borsa condiviso: ogni exchange sceglie la propria regione cloud, la maggior parte si appoggia a infrastrutture cloud pubbliche e le loro API sono di solito servite tramite content delivery network (CDN) che fanno sembrare l’exchange vicino quando non lo è. Questo rende la misurazione sia più facile (puoi noleggiare un server nella stessa regione cloud al prezzo di una cena) sia più ingannevole (i test ovvi misurano la cosa sbagliata).
Quanto conta la latenza dipende dalla strategia:
| Strategia | Quanto dura di solito l’opportunità | Latenza "sufficiente" |
|---|---|---|
| Arbitraggio cross-exchange con trasferimenti tra exchange | Minuti (limitati dalle conferme on-chain) | Secondi; commissioni e tempi di trasferimento contano molto di più |
| Operazioni su funding rate e sulla base spot-futures | Da ore a giorni | Non critica; la qualità di esecuzione conta più della velocità |
| Arbitraggio hedge (a due gambe) con saldi già depositati su entrambi gli exchange | Da centinaia di millisecondi a secondi sulle coppie mid-cap, meno sulle major | Decine di millisecondi verso ciascun exchange |
| Arbitraggio di latenza contro una piattaforma più lenta, in concorrenza con i market maker | Millisecondi | Pochi millisecondi (una cifra) verso la piattaforma su cui operi, stessa regione cloud |
Se il tuo vantaggio deriva da gap strutturali lenti, come l’arbitraggio sul funding rate o trasferimenti limitati dalle commissioni di prelievo e dai tempi di conferma della rete, non ti serve nulla di questa guida oltre a un server stabile. Se fai trading sulle differenze di prezzo tra book degli ordini, è la differenza tra essere eseguito e inseguire il prezzo.
Il budget di latenza: dove vanno i millisecondi
La "latenza" non è un numero solo. Un ordine che reagisce a un movimento di mercato attraversa una catena di passaggi e ognuno aggiunge tempo. Ragionare in termini di budget ti dice quali parti puoi cambiare e quali no.
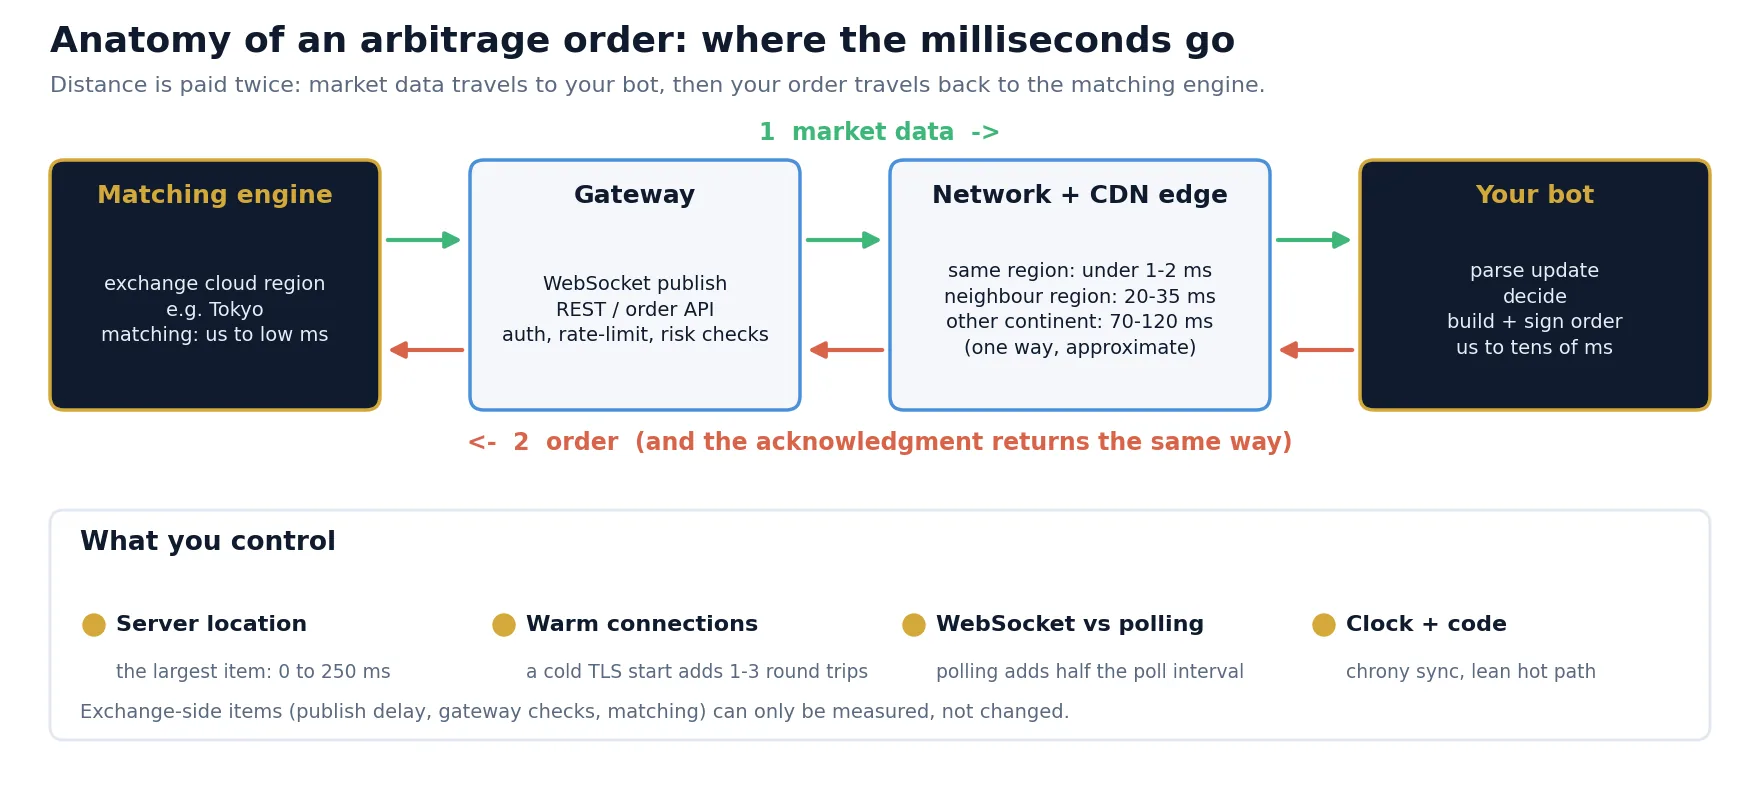
| Componente | Intervallo tipico (approssimativo) | Chi lo controlla |
|---|---|---|
| Pubblicazione dei dati di mercato (dal motore al gateway WebSocket) | Da meno di un millisecondo a diversi millisecondi; di più per stream aggregati o limitati | Exchange; il tipo di stream lo scegli tu |
| Rete, sola andata, stessa regione cloud | Da meno di 1 ms a circa 2 ms | Tu, con la scelta dell’hosting |
| Rete, sola andata, regioni asiatiche vicine (es. da Tokyo a Hong Kong) | Circa 20-35 ms | Tu |
| Rete, sola andata, tra continenti (es. dall’Europa o dal Nord America a Tokyo) | Circa 70-120 ms | Tu |
| Apertura della connessione (handshake TCP e TLS) su una connessione fredda | Da uno a tre round trip di rete aggiuntivi | Tu: mantieni le connessioni calde |
| Il tuo codice decisionale | Da microsecondi a decine di millisecondi | Tu |
| Gateway API, autenticazione, controlli di rate limit e di rischio | Da pochi millisecondi a decine di millisecondi, con picchi nei mercati volatili | Exchange |
| Matching | Da microsecondi a pochi millisecondi | Exchange |
Lo schema è chiaro: le due voci sotto il tuo controllo che si misurano in decine o centinaia di millisecondi sono dove si trova il tuo server e se le tue connessioni sono calde. Tutto il resto o appartiene all’exchange o è piccolo se il software è scritto con buon senso. Ecco perché il resto di questa guida si concentra su posizione e misurazione.
Dove gli exchange crypto fanno girare i motori di matching
Gli exchange pubblicano raramente la posizione esatta dei loro motori di matching, ma la maggior parte gira su cloud pubblico e la regione si può dedurre da misurazioni di latenza effettuate da molte regioni cloud. Le misurazioni indipendenti pubblicate da terze parti nel 2026 concordano sulla maggior parte delle grandi piattaforme. La tabella riassume le regioni riportate pubblicamente. Considerala un punto di partenza per i tuoi test, non una garanzia: gli exchange si spostano (BitMEX, per esempio, avrebbe trasferito il suo motore da Dublino a Tokyo nel 2025).
| Exchange | Regione del motore riportata pubblicamente | Regione cloud da testare per prima | Affidabilità |
|---|---|---|---|
| Binance | Tokyo | AWS ap-northeast-1 | Alta: coerente tra misurazioni indipendenti |
| Bybit | Singapore | AWS ap-southeast-1 | Alta |
| OKX | Hong Kong | AWS ap-east-1 | Alta |
| Gate.io, KuCoin, Bitget, HTX | Tokyo | AWS ap-northeast-1 | Da media ad alta |
| Coinbase (spot) | Stati Uniti, costa orientale | AWS us-east-1 | Media: API dietro una CDN, misura le conferme degli ordini |
| Kraken | Europa | Testa Londra, Dublino e Francoforte | Bassa: le fonti pubblicate non concordano |
| Deribit | Area di Londra | AWS eu-west-2 | Da media ad alta |
Ne derivano due conclusioni pratiche. Primo, Tokyo è quanto di più simile a un hub di trading centrale esista nel mondo crypto: un server lì è a pochi millisecondi da Binance e da diverse altre grandi piattaforme, a circa 25 ms di sola andata da Hong Kong e a circa 35 ms di sola andata da Singapore. Secondo, qualsiasi strategia che abbini un exchange asiatico a Coinbase o a una piattaforma europea ha un limite fisico di 70-120 ms di sola andata tra i due motori, qualunque cosa tu faccia con il tuo server.
Ospitare un server in un determinato paese non cambia gli exchange che puoi utilizzare. Rispetta i termini di servizio di ogni exchange e le regole della tua giurisdizione; non usare mai server o VPN per aggirare restrizioni geografiche.
La trappola della CDN: perché il ping mente
L’errore più comune è misurare la latenza con ping o con il tempo di apertura di una connessione TCP verso il nome host dell’API. Quasi tutti i grandi exchange mettono i loro endpoint pubblici REST e WebSocket dietro una CDN o un load balancer cloud con nodi edge in tutto il mondo. Quando ti connetti a api.binance.com dall’Europa o dal Nord America, il server che risponde al tuo handshake TCP è un nodo edge in una città vicina, non il motore di matching a Tokyo. L’handshake richiede pochi millisecondi; poi il nodo edge inoltra la tua richiesta lungo la dorsale del provider fino all’origine reale, ed è lì che se ne va il tempo.
Quindi un ping di 5 ms verso il nome host di un exchange può convivere con un tempo reale di richiesta di 150 ms. Gli unici numeri che hanno senso sono quelli che includono il viaggio fino all’origine: il tempo al primo byte di una risposta API reale su una connessione già aperta, il ritardo tra il timestamp dell’evento dell’exchange e il tuo tempo di ricezione sul WebSocket, e il tempo dall’invio di un ordine alla ricezione della sua conferma.
Misurato da BJF Trading Group il 7 novembre 2026 da un web server a Montreal (Leaseweb), endpoint pubblici dell’orario, due esecuzioni da una richiesta fredda più 20 calde per exchange.
Cosa abbiamo misurato da un server a Montreal
Per mostrare l’effetto con numeri reali anziché con le dichiarazioni dei fornitori, abbiamo eseguito una piccola sonda dal web server che ospita questo sito, a Montreal. Per otto exchange ha aperto una connessione, inviato una richiesta (fredda), poi altre 20 richieste sulla stessa connessione keep-alive (calde), a quattro richieste al secondo, e ha ripetuto l’intera esecuzione due volte. L’endpoint era la chiamata pubblica dell’orario del server di ciascun exchange, che non fa quasi nessun lavoro, quindi il risultato è vicino al puro tempo di trasporto più il tempo del gateway.
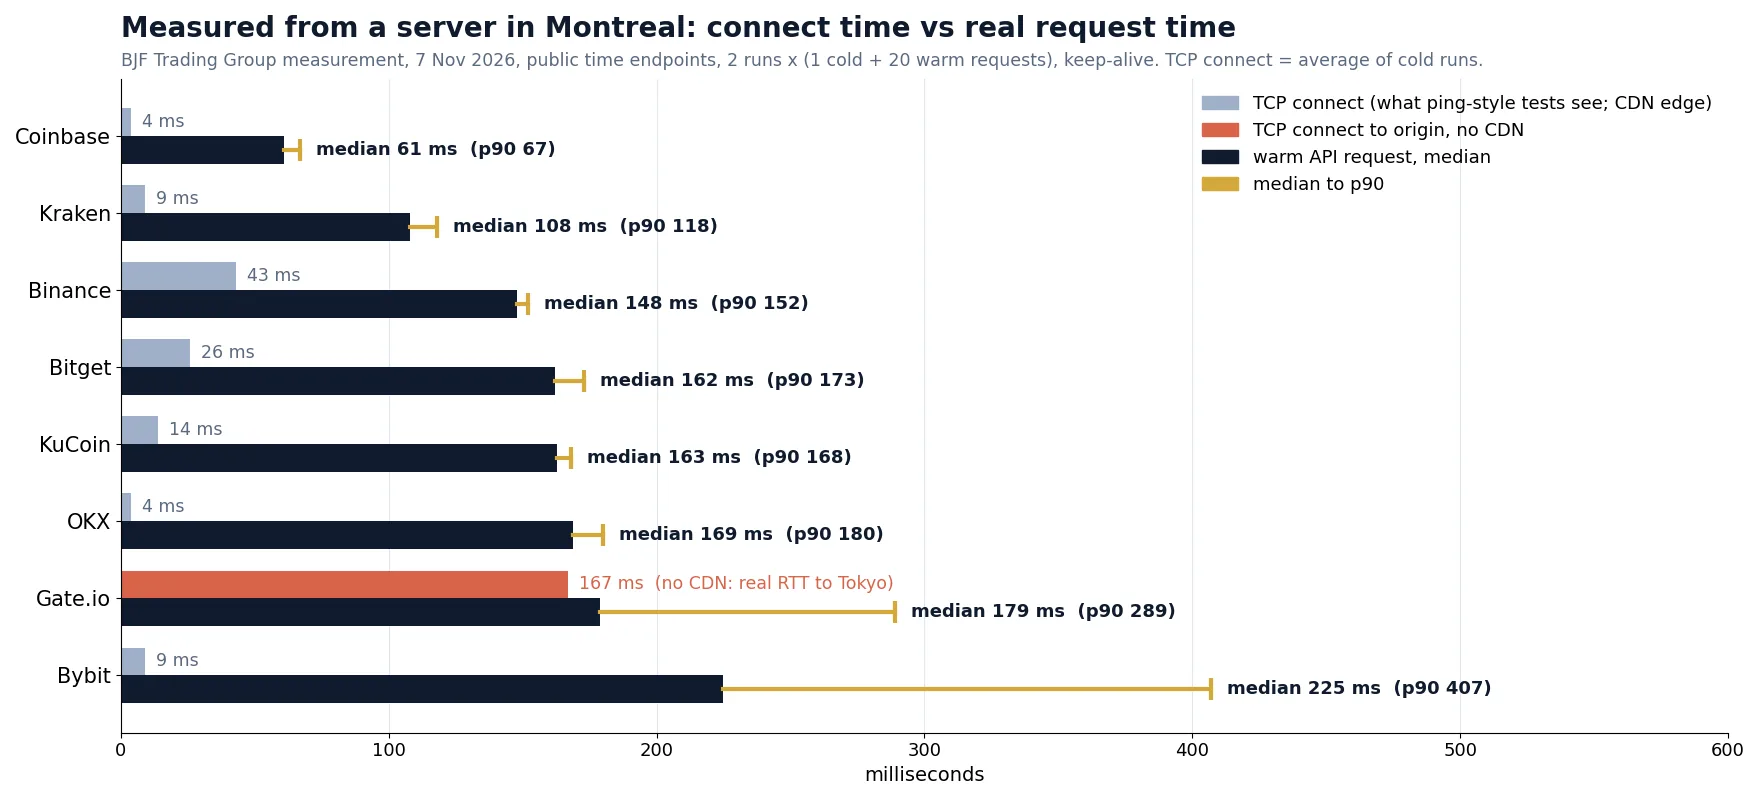
| Exchange | Front end visto da Montreal | Connessione TCP, ms | Prima richiesta fredda, ms | Mediana richieste calde, ms | p90 calde, ms |
|---|---|---|---|---|---|
| Coinbase | Nodo edge Cloudflare | 4 | 119-140 | 61 | 67 |
| Kraken | Nodo edge Cloudflare | 3-15 | 162-179 | 108 | 118 |
| Binance | Nodo edge CloudFront | 11-74 | 210-277 | 148 | 152 |
| Bitget | Nodo edge Cloudflare | 15-37 | 226-247 | 162 | 173 |
| KuCoin | Nodo edge Cloudflare | 6-23 | 220-244 | 163 | 168 |
| OKX | Nodo edge Cloudflare | 3-4 | 217-232 | 169 | 180 |
| Gate.io | Diretto, indirizzo AWS di Tokyo | 167 | 668-718 | 179 | 289 |
| Bybit | Nodo edge CloudFront | 8-10 | 278-281 | 225 | 407 |
Da questo piccolo test emergono quattro lezioni:
- Dietro una CDN il tempo di connessione non significa nulla. OKX ha risposto all’handshake TCP in 3-4 ms, eppure ogni richiesta reale ha richiesto circa 170 ms, perché il lavoro avviene a Hong Kong.
- La classifica segue la geografia. Da Montreal il più veloce è Coinbase (costa orientale degli USA), secondo Kraken (Europa), mentre gli exchange asiatici si raggruppano tra 150 e 225 ms. Da Tokyo l’ordine sarebbe invertito.
- Le connessioni fredde costano care. Senza un nodo edge vicino, ogni round trip di handshake attraversa il Pacifico: la prima richiesta a Gate.io ha richiesto circa 0.7 secondi, le successive circa 0.18 secondi. Un bot che apre una nuova connessione quando vede un segnale ha già perso.
- Le code contano. La mediana di Bybit era 225 ms, ma una richiesta su dieci ha superato i 400 ms. Una gamba di arbitraggio è veloce solo quanto i suoi casi lenti, quindi guarda sempre p90 e p99, non solo la mediana.
Questi numeri descrivono un web server in un pomeriggio, non un setup di trading, e includono l’elaborazione del gateway di ciascun exchange. Non sono una classifica degli exchange. Il loro scopo è mostrare l’entità degli effetti: geografia e gestione delle connessioni spiegano oltre il 90% del ritardo subito da un bot lontano.
Passo dopo passo: misurare correttamente la latenza degli exchange
Puoi riprodurre una misurazione significativa da qualsiasi server in un’ora. Il metodo qui sotto è quello che consigliamo prima di scegliere una regione di hosting o dopo qualsiasi modifica alla tua infrastruttura.
Per il passo 2, un semplice curl basta per iniziare. Ripetendo l’URL, curl riutilizza un’unica connessione; la prima riga è la richiesta fredda, le altre sono calde:
curl -s –rate 4/s -w "%{num_connects} %{time_connect} %{time_starttransfer}\n" -o /dev/null URL -o /dev/null URL -o /dev/null URL
Per i passi 4 e 5 ti servono poche righe di codice nel linguaggio usato dal tuo bot, perché la misurazione deve passare per la stessa libreria client, lo stesso parser JSON e le stesse impostazioni di connessione del trading reale. Un numero prodotto da uno strumento diverso ti parla di quello strumento.
Dati di mercato via WebSocket e sincronizzazione dell’orologio
Per tutto ciò che è sensibile al tempo, i dati di mercato devono arrivare da stream WebSocket, non dal polling REST. Un ciclo di polling che richiede il book degli ordini ogni 200 ms aggiunge in media 100 ms di attesa prima ancora di vedere una variazione, oltre al tempo della richiesta, e consuma il budget di rate limit che ti serve per gli ordini. Uno stream WebSocket invia ogni aggiornamento non appena l’exchange lo pubblica. I dettagli su stream, book locali e controlli di sequenza sono trattati nella nostra guida su come collegarsi alle API degli exchange crypto per l’arbitraggio; qui ci concentriamo sulle tempistiche.
Misurare il ritardo del feed
La maggior parte dei messaggi WebSocket degli exchange contiene un timestamp impostato dall’exchange: un orario dell’evento, del trade o del messaggio, di solito in millisecondi. Sottrailo dal tuo orario locale di ricezione e ottieni il ritardo del feed, che include il ritardo interno di pubblicazione dell’exchange e il viaggio in rete. Registralo per ciascuno stream, non solo come media: snapshot di profondità, aggiornamenti incrementali del book e stream dei trade possono comportarsi in modo diverso, e gli stream aggregati che pubblicano ogni 100 ms mostreranno un andamento a dente di sega.
Perché l’orologio conta
Le misurazioni di sola andata valgono quanto l’allineamento tra il tuo orologio e quello dell’exchange. Se l’orologio del tuo server è indietro di 15 ms, ogni ritardo del feed sembrerà migliore di 15 ms rispetto alla realtà. Su un server cloud, esegui chrony con il servizio orario del provider e controlla chronyc tracking: un offset entro circa un millisecondo è una base solida per confrontare le regioni. Molti exchange espongono anche un endpoint con l’orario del server; confrontarlo con il tuo orologio tenendo conto di metà del round trip misurato fornisce una verifica approssimativa. Gli endpoint degli ordini che accettano una finestra di ricezione (un’età massima consentita del timestamp della richiesta) rifiutano inoltre gli ordini quando il tuo orologio deriva, un motivo in più per tenerlo sincronizzato.
Misura separatamente il percorso degli ordini
Il ritardo del feed ti dice quanto è vecchia la tua visione del mercato. Il round trip dell’ordine ti dice quanto tempo serve per agire. I due valori spesso differiscono: le richieste di ordine passano per autenticazione, conteggio dei rate limit e controlli di rischio che uno stream di dati di mercato non attraversa. Alcuni exchange, tra cui Binance, offrono un endpoint di test degli ordini che convalida un ordine firmato senza inviarlo al motore di matching; misura la parte di rete e di gateway. Dove l’exchange offre l’inserimento degli ordini tramite WebSocket o sessione FIX, misura anche quello, perché una sessione persistente evita l’overhead per singola richiesta.
Scegliere la regione di hosting per l’arbitraggio tra due exchange
Per un singolo exchange la risposta è semplice: noleggia un server nella stessa regione cloud del suo motore. L’arbitraggio tra due exchange è invece un problema di geometria, perché i motori si trovano in luoghi diversi e puoi stare accanto solo a uno dei due.
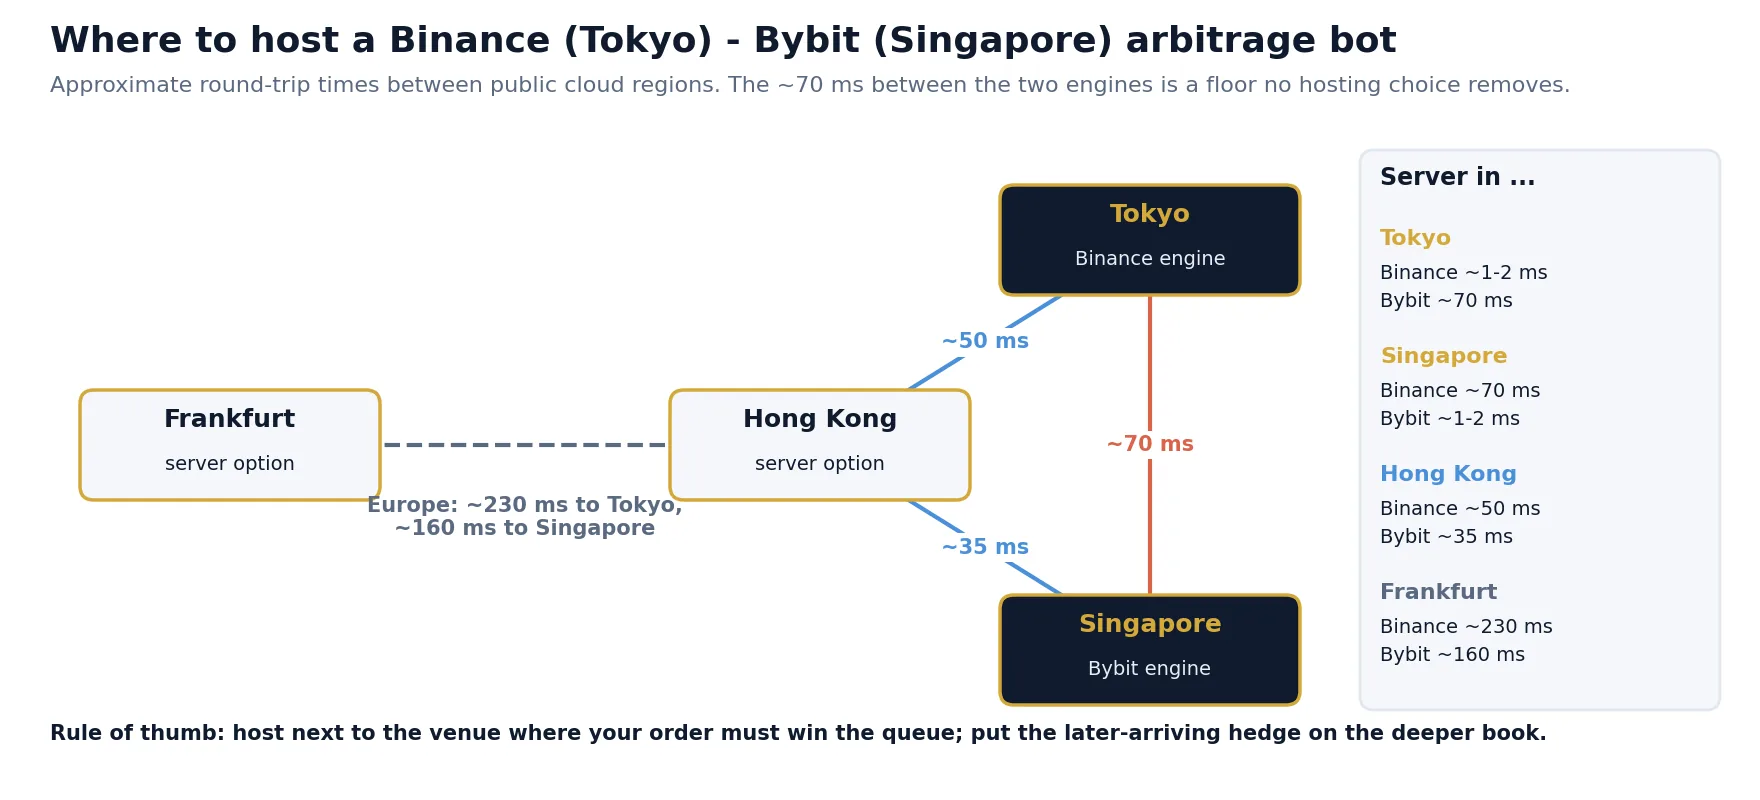
Prendiamo un arbitraggio hedge tra Binance (Tokyo) e Bybit (Singapore). Il round trip tra le due regioni è di circa 70 ms, quindi circa 35 ms di sola andata. Vediamo le opzioni principali:
| Posizione del server | Round trip verso Binance | Round trip verso Bybit | Valutazione |
|---|---|---|---|
| Tokyo | Circa 1-2 ms | Circa 70 ms | Veloce su Binance, la gamba su Bybit paga tutta la distanza |
| Singapore | Circa 70 ms | Circa 1-2 ms | L’immagine speculare |
| Hong Kong | Circa 50 ms | Circa 35 ms | Lento su entrambe le gambe; raramente la scelta migliore per due piattaforme |
| Europa (es. Francoforte) | Circa 230 ms | Circa 160 ms | Fuori gara per qualsiasi strategia sensibile al tempo |
I round trip sono valori tipici approssimativi tra regioni cloud pubbliche; verifica i dati aggiornati tra regioni del tuo provider e misura dai tuoi server.
L’osservazione chiave è che l’informazione deve sempre attraversare la distanza tra i due exchange. Se il prezzo si muove su Binance e la quotazione non aggiornata si trova su Bybit, un server a Tokyo vede subito il movimento e il suo ordine viaggia 35 ms fino a Singapore; un server a Singapore riceve il movimento con 35 ms di ritardo e il suo ordine arriva subito. Il totale è lo stesso. Ciò che cambia è quale parte della catena aspetta, e quindi quale criterio dovrebbe guidare la scelta:
- Ospita il server accanto alla piattaforma dove l’ordine deve vincere. Se il tuo profitto dipende dal colpire una quotazione prima degli altri trader su un exchange, competi dove si decide quella coda. Lì le informazioni di tutti sull’altro exchange arrivano alla stessa velocità, ma il tuo ordine non deve viaggiare.
- Metti l’hedge sul book più profondo. La gamba che raggiunge il suo exchange più tardi dovrebbe essere quella meno sensibile a pochi millisecondi: il book più liquido, dove è improbabile che il prezzo di copertura si muova molto.
- Conosci rapidamente lo stato di esecuzione. Stare accanto all’exchange dove le esecuzioni parziali sono frequenti ti permette di dimensionare l’hedge su informazioni accurate, riducendo il rischio non coperto.
- Dividi solo quando conviene. Due processi, uno per regione, possono ciascuno mantenere un book locale e reagire localmente, ma devono coordinarsi sullo stesso collegamento da 70 ms. Questo aggiunge complessità e possibili punti di guasto e conviene soprattutto per setup professionali.
Per strategie su tre o più piattaforme asiatiche, Tokyo è di solito il centro pratico per via del numero di grandi exchange presenti. Per le coppie che includono una piattaforma statunitense o europea, domina la gamba intercontinentale e la strategia deve tollerare 70-120 ms di sola andata, il che esclude la pura competizione sulla velocità e favorisce gap più ampi e duraturi.
Come la latenza si trasforma in denaro
Una differenza di prezzo tra due book degli ordini non è un premio fisso. Anche gli altri trader la vedono, i market maker aggiornano le loro quotazioni e il gap scompare in un tempo che dipende dall’asset e dalla piattaforma. Un modo semplice di ragionarci è supporre che ogni opportunità sopravviva per un tempo casuale con una vita media, e chiedersi quanto sia probabile che sia ancora lì quando arriva il tuo ordine.
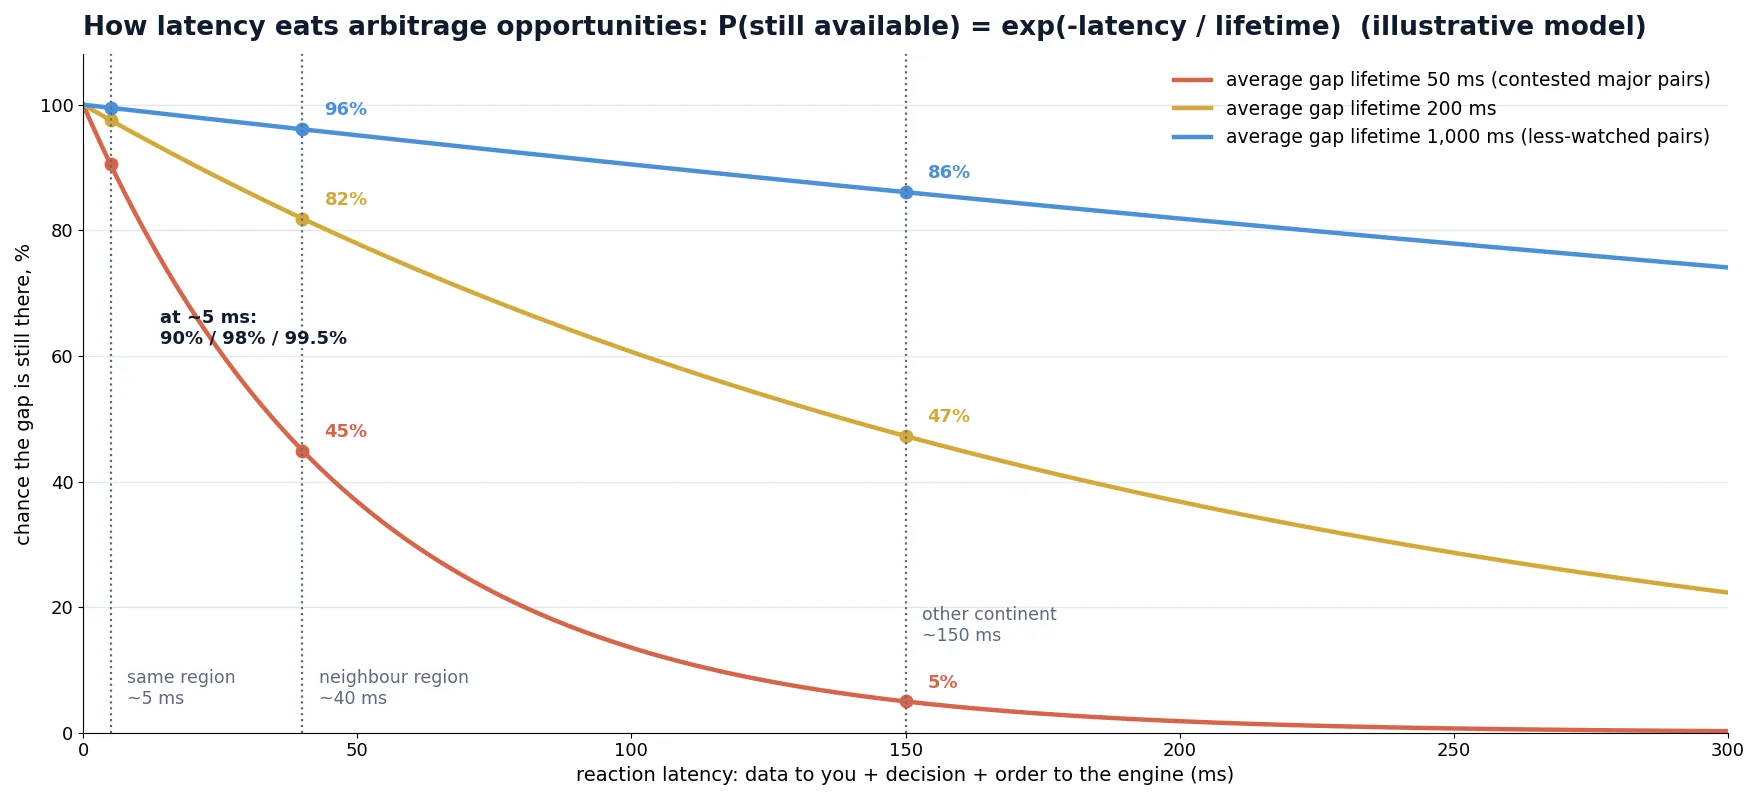
In questo modello la probabilità che un gap sia ancora presente dopo un tempo di reazione di L millisecondi è exp(−L / τ), dove τ è la vita media del gap. Ecco i risultati per tre tempi di reazione, che corrispondono grosso modo a un server nella stessa regione (5 ms), in una regione vicina (40 ms) e in un altro continente (150 ms):
| Vita media del gap | Reazione 5 ms | Reazione 40 ms | Reazione 150 ms |
|---|---|---|---|
| 50 ms (gap contesi sulle coppie major) | 90% | 45% | 5% |
| 200 ms | 98% | 82% | 47% |
| 1,000 ms (coppie meno osservate) | 99.5% | 96% | 86% |
Ora associamoci del denaro. Supponiamo che una strategia trovi 200 segnali al giorno con un vantaggio netto dello 0.10% su un trade da 5,000 USDT, cioè 5 USDT per segnale catturato, e che un segnale mancato costi in media 1.5 USDT, perché una gamba è stata eseguita e va chiusa. Per gap con una vita di 200 ms:
| Posizione del server | Catturati | Valore atteso per segnale | Al giorno (200 segnali) |
|---|---|---|---|
| Stessa regione (5 ms) | 98% | 0.98 × 5 − 0.02 × 1.5 = 4.87 USDT | Circa 974 USDT |
| Regione vicina (40 ms) | 82% | 0.82 × 5 − 0.18 × 1.5 = 3.83 USDT | Circa 766 USDT |
| Altro continente (150 ms) | 47% | 0.47 × 5 − 0.53 × 1.5 = 1.56 USDT | Circa 311 USDT |
I numeri sono ipotetici, ma la conclusione è solida: spostare un bot da un altro continente nella regione giusta può moltiplicare il risultato della stessa strategia, mentre passare da una regione vicina alla stessa regione aggiunge un miglioramento più piccolo ma comunque significativo. Mostra anche il limite: per gap che durano un secondo o più, la latenza conta poco e il risultato lo decidono commissioni, slippage e inventario. Prima di investire in infrastruttura, verifica quanto durano davvero i gap su cui operi; lo scanner gratuito di arbitraggio crypto ti permette di osservare in tempo reale le differenze di prezzo effettive tra exchange.
Colocation, VPS e cosa è realistico per i trader indipendenti
Nel forex e nelle azioni, colocation significa noleggiare spazio rack nello stesso data center dei server della borsa o del broker, e i principali hub sono ben noti (vedi la nostra guida su VPS per l’arbitraggio forex e hub di colocation). Nel mondo crypto l’equivalente per la maggior parte dei trader è semplicemente un server virtuale nella stessa regione cloud dell’exchange. Poiché il motore stesso gira in quel cloud, un server nella stessa regione è già a uno o due millisecondi da esso, per un costo di qualche decina di dollari al mese.
| Opzione | Latenza tipica verso il motore | Costo | Per chi è |
|---|---|---|---|
| PC di casa o connessione dell’ufficio | Da decine a centinaia di ms, instabile | Nessuno | Monitoraggio, strategie lente, test |
| VPS in un’altra regione o continente | 70-250 ms | Basso | Arbitraggio su funding, base e trasferimenti |
| Server cloud nella regione dell’exchange | Circa 1-2 ms di round trip sulla rete | Da basso a moderato | Arbitraggio hedge e la maggior parte delle strategie retail sensibili alla latenza |
| Stessa availability zone, istanze ottimizzate | Guadagni di rete inferiori al millisecondo | Moderato | Team professionali che hanno già ottimizzato tutto il resto |
| Connettività dedicata o programmi per market maker | La più bassa disponibile | Alto, di solito legato ai livelli di volume | Market maker e istituzioni |
All’interno di una regione, la availability zone può fare un’ulteriore differenza di una frazione di millisecondo. Conta solo quando competi con market maker professionisti sulle coppie più liquide, e vale la pena testarla solo dopo aver sistemato le voci più grandi: regione, connessioni calde, dati via WebSocket e il tuo codice. I principi generali su quanto debba essere veloce un server, e perché la bassa latenza conti più delle specifiche elevate, sono trattati in quanto deve essere veloce il tuo VPS per l’arbitraggio.
La latenza dentro il tuo software
Una volta che il server è nel posto giusto, i ritardi rimanenti sono per lo più autoinflitti. I soliti colpevoli, nell’ordine in cui li vediamo:
- Aprire le connessioni al bisogno. Mantieni attive le connessioni REST con un connection pool, invia periodicamente una richiesta leggera perché le connessioni inattive non vengano chiuse e riconnetti i WebSocket in modo proattivo prima della durata massima di sessione dell’exchange.
- Polling invece di streaming. Usa dati di mercato via WebSocket e, dove disponibile, l’inserimento degli ordini via WebSocket o FIX.
- Lavoro pesante sul percorso critico. Scrivere log su disco, analizzare grandi messaggi JSON campo per campo o ricalcolare l’intero book a ogni aggiornamento aggiungono millisecondi. Fai il minimo indispensabile prima di inviare l’ordine e rimanda il resto.
- Penalità per i rate limit. Un bot che supera il limite di peso delle richieste viene rifiutato o bloccato temporaneamente, il che equivale a una latenza infinita. Assegna un budget di richieste per ciascun exchange e rallenta prima del limite, non dopo.
- Garbage collection e contesa della CPU. Su un piccolo VPS condiviso, altri utenti della macchina e le pause di pulizia della memoria possono aggiungere decine di millisecondi in momenti casuali. Questo si vede nel p99, non nelle medie.
- Invio sequenziale delle gambe. Se entrambe le gambe di un hedge sono indipendenti, inviale in parallelo invece di aspettare la prima conferma.
Il software VIP Crypto Arbitrage di BJF Trading Group si collega agli exchange centralizzati spot e futures tramite le loro API native e gira su un server scelto da te, quindi i principi di posizionamento di questa guida si applicano direttamente. Per la logica delle strategie basate sulla latenza, consulta la nostra guida all’arbitraggio di latenza e, per il quadro generale delle strategie cross-exchange, la panoramica sull’arbitraggio crypto.
Rischi e limiti
- La latenza da sola non è un vantaggio. Essere veloci serve solo se la strategia è redditizia al netto di commissioni, slippage e costi di inventario. Un bot veloce con un vantaggio negativo perde denaro più in fretta.
- Le posizioni cambiano. Gli exchange spostano i motori e cambiano provider CDN. Una regione giusta l’anno scorso potrebbe non esserlo oggi; misura di nuovo regolarmente.
- Le misurazioni sono locali. I nostri numeri da Montreal, come qualsiasi tabella pubblicata, descrivono un luogo e un momento. Per le tue decisioni sono valide solo le misurazioni fatte dal tuo server, tramite il tuo software.
- Sotto stress dominano i ritardi lato exchange. Nei mercati violenti i gateway mettono in coda le richieste e le conferme rallentano per tutti. La tua strategia deve tollerarlo, per esempio limitando la dimensione delle posizioni quando i tempi di conferma aumentano.
- La corsa agli armamenti non ha fine. Sulle coppie più liquide le società professionali investono nella velocità molto più di quanto possa fare un trader indipendente. Cerca gap che durino abbastanza per il tuo setup invece di competere su quelli più brevi.
- Conformità. La posizione del server non cambia la tua situazione legale. Usa solo exchange e prodotti disponibili per te e rispetta i termini delle API e i rate limit.
Verifica quanto durano i gap reali prima di ottimizzare
Osserva le differenze di prezzo reali tra exchange centralizzati, quanto sono ampie e quanto rapidamente si chiudono. Poi decidi quanta latenza può tollerare la tua strategia.
Scarica il Crypto Arbitrage Scanner gratuitoSoftware VIP Crypto Arbitrage
Scanner di arbitraggio gratuito + breve corso via email
Ricevi il link allo scanner gratuito e alcune email brevi e pratiche di Boris: cosa significa davvero un divario di prezzo dopo i costi, come testare una strategia prima di rischiare denaro reale e quali strumenti sono adatti al tuo mercato. Niente promesse esagerate. Le email sono in inglese.
Domande frequenti
Che cos’è il trading crypto a bassa latenza?
È fare trading con il ritardo più breve possibile tra un evento di mercato su un exchange e l’arrivo del tuo ordine al motore di matching di quell’exchange. In pratica significa ospitare il server di trading nella stessa regione cloud dell’exchange, usare dati via WebSocket e connessioni calde, e mantenere veloce il tuo codice.
Dove si trovano i server di Binance?
Le misurazioni di latenza indipendenti collocano costantemente il motore di matching di Binance a Tokyo, nella regione AWS ap-northeast-1. La sua API pubblica è servita tramite una CDN, quindi il server che risponde a un ping è di solito un nodo edge vicino a te; per averne conferma misura i tempi reali di richieste e ordini.
Il ping è un buon modo per misurare la latenza di un exchange?
No. La maggior parte delle API degli exchange si trova dietro CDN, quindi ping e tempi di connessione TCP misurano solo la distanza dal nodo edge più vicino. Nel nostro test da Montreal, OKX ha risposto all’handshake TCP in 3-4 ms ma ogni richiesta reale ha richiesto circa 170 ms. Misura invece il tempo al primo byte su una connessione calda, il ritardo del feed e il tempo di conferma degli ordini.
Mi serve la colocation per l’arbitraggio crypto?
Per la maggior parte dei trader indipendenti, no. Poiché i principali exchange girano in regioni cloud pubbliche, un server nella stessa regione è già a uno o due millisecondi dal motore. Esistono programmi di connettività dedicata per market maker e account ad alto volume, ma contano solo dopo aver ottimizzato tutto il resto.
Quale latenza è sufficiente per l’arbitraggio crypto?
Dipende da quanto durano i gap. Le strategie su funding rate, base e trasferimenti funzionano con secondi di ritardo. L’arbitraggio hedge con saldi su entrambi gli exchange richiede di solito decine di millisecondi verso ciascuna piattaforma. Competere per i gap più brevi sulle coppie major richiede pochi millisecondi dalla stessa regione.
Qual è la regione migliore per fare trading su più exchange crypto?
Tokyo è di solito la migliore posizione singola per gli exchange asiatici, perché lì si trovano Binance e diverse altre grandi piattaforme, mentre Hong Kong e Singapore distano circa 25-35 ms di sola andata. Se i tuoi exchange sono distribuiti su più continenti, scegli la posizione della piattaforma dove i tuoi ordini devono essere più veloci.
Il WebSocket è più veloce del REST per i dati di mercato crypto?
Sì, ai fini pratici. Uno stream WebSocket invia ogni aggiornamento quando l’exchange lo pubblica, mentre il polling REST aggiunge tempo di attesa tra le richieste più una richiesta completa per ogni controllo, e consuma i rate limit. Usa il REST soprattutto per snapshot, interrogazioni sull’account e ripristino.
Questo articolo ha scopo educativo e non costituisce consulenza finanziaria. I dati di latenza nella tabella di Montreal sono stati misurati da BJF Trading Group il 7 novembre 2026 da un solo server e non sono una classifica degli exchange; le informazioni sulle regioni si basano su misurazioni di terze parti riportate pubblicamente e possono cambiare. I dati e i grafici indicati come illustrativi o approssimativi sono modelli e valori tipici, non misurazioni di uno specifico exchange o trader.
